图的遍历
深度优先搜索
深度优先搜索 (Depth-First Search, DFS) 类似二叉树的先序遍历: 访问当前顶点后, 沿一条边尽量往深处走, 走不通再基于栈进行回溯, 换下一条边.
树没有环, 先序遍历不会重复碰到同一结点. 图可以有环, 必须另备 visited[], 每个顶点只访问一次, 否则会在环上打转.
算法思想
从任意顶点 \(v\) 出发:
-
访问 \(v\), 并标记为已访问
-
在 \(v\) 的邻接点里挑一个尚未访问的 \(w\), 对 \(w\) 递归做同样的事 (继续深入)
-
\(v\) 的邻接点全部访问过之后, 回溯到调用 \(v\) 的那个顶点, 换另一条未走完的边
-
若图不连通, 对每个尚未访问的顶点再调一次 DFS, 直到所有顶点都被访问
迷宫模型
想象一个迷宫模型, 走进死胡同就退回岔路口, 换另一条路, 这就是回溯(backtrack)的基本思想.
初学时可能会纠结迷宫应该怎么实现, 其实若规模不大, 只需一个二维数组, 用0表示通路, 1表示障碍:
int maze[MAX_ROW][MAX_COL] = {
    {0, 1, 0, 0, 0},
    {0, 1, 0, 1, 0},
    {0, 0, 0, 0, 0},
    {0, 1, 1, 1, 0},
    {0, 0, 0, 1, 0},
};
用2来表示已经走过的格子:
void visit(int row, int col, struct point pre, int maze[MAX_ROW][MAX_COL],
       struct point predecessor[MAX_ROW][MAX_COL])
{
    struct point visit_point = { row, col };
    maze[row][col] = 2;
    predecessor[row][col] = pre;
    push(visit_point);
}
上面的visit函数中:
-
pre表示当前格子的前一个格子 -
visit_point表示当前遍历到的格子 -
maze[row][col] = 2表示当前格子已经走过, 用2来覆盖 -
predecessor[row][col] = pre表示当前格子的前一个格子是pre, 用于辅助记录路径, 即每次遍历到某个格子时, 记录下它是从哪个格子走过来的. -
push(visit_point)表示将当前格子压栈, 便于后续的回溯:void push(struct point p) { stack[top++] = p; }思考我们需要回溯时的情况, 在DFS中, 只有在走不通时才需要回溯, 因此我们需要一个栈来记录路径, 记录的内容也很简单, 就是走过的格子. 这样, 栈中的序列就自底向上存储了从起点到当前格子的路径.
基于栈LIFO的特性, 我们每次回溯时, 只需要弹出栈顶元素, 返回值就是当前格子的前一个格子, 这样我们就可以回溯到前一个格子, 继续尝试其他方向:
struct point pop() { return stack[--top]; }后进先出逼着算法先把一条路走到底, 这才叫深度优先. 每个格子的前驱只有一个, 后继却可能有多个 (探索时往好几个方向都试过), 所以用前驱数组能从终点倒推回起点, 却不能只存一个后继来正向打印整条正确路线.
迭代实现
思考完遍历访问的方式以及路径存储与回溯的形式后, 我们就可以开始实现DFS的主逻辑了:
int dfs_traverse_base_iter(int maze[MAX_ROW][MAX_COL],
               struct point predecessor[MAX_ROW][MAX_COL])
{
    struct point p = { 0, 0 };

    maze[p.row][p.col] = 2;
    push(p);

    while (!is_empty()) {
        p = pop();
        if (p.row == MAX_ROW - 1    /* goal */
            && p.col == MAX_COL - 1)
            break;
        if (p.col + 1 < MAX_COL /* right */
            && maze[p.row][p.col + 1] == 0)
            visit(p.row, p.col + 1, p, maze, predecessor);
        if (p.row + 1 < MAX_ROW /* down */
            && maze[p.row + 1][p.col] == 0)
            visit(p.row + 1, p.col, p, maze, predecessor);
        if (p.col - 1 >= 0  /* left */
            && maze[p.row][p.col - 1] == 0)
            visit(p.row, p.col - 1, p, maze, predecessor);
        if (p.row - 1 >= 0  /* up */
            && maze[p.row - 1][p.col] == 0)
            visit(p.row - 1, p.col, p, maze, predecessor);
        print_maze(maze);
        sleep(1);
    }
    if (p.row == MAX_ROW - 1 && p.col == MAX_COL - 1) {
        printf("(%d, %d)\n", p.row, p.col);
        while (predecessor[p.row][p.col].row != -1) {
            p = predecessor[p.row][p.col];
            printf("(%d, %d)\n", p.row, p.col);
        }
    } else {
        return 0;
    }
    return 1;
}
抹去细节, 只保留主要逻辑就是这样:
/* 将起点标记为已走过并压栈; */
while (/*栈非空*/) {
    /* 弹出栈顶格子 p; */
    if (/* p 是终点 */) break;
    /* 否则按右 / 下 / 左 / 上探索相邻格子; */
    if (/* 相邻格可走且未走过 */)
        /* 标记为已走过, 记下前驱为 p, 压栈; */
}
递归实现
既然我们用到了栈, 回顾递归调用的本质, 我们完全可以直接让系统帮我们维护一个栈, 这样我们就 可以避免显式使用栈带来的维护成本.
进入 dfs 相当于 push 当前格, return 相当于 pop / 回溯.
但是需要注意的是, 这并不是和迭代版字面上一一映射: 迭代一次循环可能把四个邻居都 push(这也是在执行时迭代版会出现遍历到路口时会先把路口的各个方向都先探出一格的原因1);
递归则是对一个邻居调用一次, 整段走完 (或已经找到) 才试下一个, 所以运气好的话会出现只走一条路就找到终点的情况:
Recursive implementation:
2 1 0 0 0
0 1 0 1 0
0 0 0 0 0
0 1 1 1 0
0 0 0 1 0
*********
2 1 0 0 0
2 1 0 1 0
0 0 0 0 0
0 1 1 1 0
0 0 0 1 0
*********
2 1 0 0 0
2 1 0 1 0
2 0 0 0 0
0 1 1 1 0
0 0 0 1 0
*********
2 1 0 0 0
2 1 0 1 0
2 2 0 0 0
0 1 1 1 0
0 0 0 1 0
*********
2 1 0 0 0
2 1 0 1 0
2 2 2 0 0
0 1 1 1 0
0 0 0 1 0
*********
2 1 0 0 0
2 1 0 1 0
2 2 2 2 0
0 1 1 1 0
0 0 0 1 0
*********
2 1 0 0 0
2 1 0 1 0
2 2 2 2 2
0 1 1 1 0
0 0 0 1 0
*********
2 1 0 0 0
2 1 0 1 0
2 2 2 2 2
0 1 1 1 2
0 0 0 1 0
*********
2 1 0 0 0
2 1 0 1 0
2 2 2 2 2
0 1 1 1 2
0 0 0 1 2
*********
Path found!
某一时刻还没返回的栈帧, 从底到顶就是起点到当前格. 这时前驱表 predecessor 不再需要了, 因为这时路径已经存储在调用堆栈上了:
| 迭代版 | 递归版 | |
|---|---|---|
| 栈里 | 待走的格子 (工作的显式栈, LIFO) | 当前这条路上还没返回的格子 |
| 路径在哪 | 不在栈上, 所以要 predecessor | 就在调用堆栈上 |
迭代循环里的三件事, 变成 dfs(row, col) 的三件事:
-
终止: 当前格是终点, 或四个方向都走不通
-
传递: 把格子标记成
2(相当于visited, 可以对比一下迭代实现中的visit函数, 结合上面阐述的递归的特性理解为什么只需要一行代码就能完成这一步) -
递归: 对每个在界内且仍是
0的邻居再调自己; 子调用返回1就立刻把1传回去, 也就不会再试别的方向了
int dfs(int row, int col, int maze[MAX_ROW][MAX_COL])
{
    maze[row][col] = 2;
    print_maze(maze);
    sleep(1);

    if (row == MAX_ROW - 1 && col == MAX_COL - 1)
        return 1;

    if (col + 1 < MAX_COL && maze[row][col + 1] == 0 && dfs(row, col + 1, maze))
        return 1;
    if (row + 1 < MAX_ROW && maze[row + 1][col] == 0 && dfs(row + 1, col, maze))
        return 1;
    if (col - 1 >= 0 && maze[row][col - 1] == 0 && dfs(row, col - 1, maze))
        return 1;
    if (row - 1 >= 0 && maze[row - 1][col] == 0 && dfs(row - 1, col, maze))
        return 1;
    return 0;   /* 四边全死, 回溯 */
}

int dfs_traverse_base_recur(int maze[MAX_ROW][MAX_COL])
{
    return dfs(0, 0, maze);
}
抹去细节:
int dfs(row, col)
{
    /* 标记为已走过; */
    if (/* 是终点 */) return 1;
    /* 按右 / 下 / 左 / 上: 可走则 dfs(邻居); */
    if (/* 子调用找到终点 */) return 1;
    return 0;
}
上面走迷宫的DFS在找到终点就停, 主要是为了阐述DFS的基本思想; 下面图上的DFS则要访问所有顶点, 通了也还要继续.
基于图的DFS抽象
将迷宫模型抽象成到数据结构图, 把每个格子当成一个顶点, 上下左右可走的相邻格当成边, 我们就可以基于数据结构来实现DFS.
下面这张无向图从 \(1\) 出发, 邻接点按编号从小到大:
graph LR
  A((1)) --- B((2))
  A --- C((3))
  B --- D((4))
  B --- E((5))
  C --- E
使用DFS的一个查找路径如下:
visit 1, 邻接 2, 3
  visit 2, 邻接 1(已访), 4, 5
    visit 4, 邻接 2(已访) → 回溯
    visit 5, 邻接 2(已访), 3
      visit 3, 邻接 1(已访), 5(已访) → 回溯
序列: 1, 2, 4, 5, 3
若邻接表里 \(1\) 的边表是 \(3\) 再 \(2\), 序列就变成 \(1, 3, 5, 2, 4\). 两种都是合法 DFS, 邻接点次序不同, 遍历序列就不同.
递归实现
递归版把「当前路径」放在调用栈里, 回溯就是函数返回.
408中习惯用 FirstNeighbor / NextNeighbor 枚举邻接点.
bool visited[MAX_VERTEX_NUM];

void DFS(Graph G, int v) {
    visit(v);
    visited[v] = true;
    for (int w = FirstNeighbor(G, v); w >= 0; w = NextNeighbor(G, v, w))
        if (!visited[w])
            DFS(G, w);          // 树边 (v, w)
}

void DFSTraverse(Graph G) {
    for (int i = 0; i < G.vexnum; ++i)
        visited[i] = false;
    for (int i = 0; i < G.vexnum; ++i)
        if (!visited[i])
            DFS(G, i);          // 每个连通分量调一次
}
DFSTraverse 外层循环保证非连通图也能扫全. 无向图里调用 DFS 的次数等于连通分量个数.
递归本质是系统帮你维护一个栈. 显式栈也能写出 DFS, 栈顶是当前正在走的顶点, 还有未访问邻接点就压进去继续深入, 没有了就弹栈回溯, 正如上面的迷宫模型所示.
迭代实现
在数据结构的抽象下, DFS的迭代实现
性能分析
时间 = 访问 \(|V|\) 个顶点 + 检查每条边的邻接关系, 瓶颈在「找出邻接点」怎么存.
| 存储 | 找一个顶点的全部邻接点 | 整图 DFS |
|---|---|---|
| 邻接矩阵 | 扫一行 \(O(\|V\|)\) | \(O(\|V\|^2)\) |
| 邻接表 | 跟边走 \(O(\deg(v))\) | \(O(\|V\| + \|E\|)\) |
空间:
-
visited[]必占 \(O(|V|)\) -
递归栈 (或显式栈) 最坏 \(O(|V|)\): 图退化成一条链时, DFS 生成树高为 \(|V|-1\)
-
合计 \(O(|V|)\), 与 BFS 同阶 (BFS 的空间在队列上)
DFS 不保证最短路
无权图上从起点到终点, DFS 找到的只是「某条」路径. 同一迷宫用队列做广度优先, 才是边数最少的那条. 带权最短路见 Dijkstra / Floyd.
深度优先生成树和生成森林
DFS 中, 从 \(v\) 第一次走到尚未访问的 \(w\) 时, 边 \((v, w)\) 称为树边. 全部树边加上被访问的顶点, 构成一棵生成树.
上面的例子, 序列 \(1, 2, 4, 5, 3\) 对应树边 \(1{-}2\), \(2{-}4\), \(2{-}5\), \(5{-}3\):
    1
    |
    2
   / \
  4   5
       \
        3
剩下的边 \(1{-}3\) 连到祖先, 是回边, 说明图里有环. 连通无向图有 \(n\) 个顶点, 生成树恰好 \(n-1\) 条树边.
DFS 树往往又高又瘦 (一条路走到底); BFS 树往往又矮又宽 (按层铺开). 二者都是生成树, 但都不是最小生成树: MST 要边权之和最小, 和遍历次序无关.
邻接表不唯一时, 深度优先生成树也不唯一, 道理和遍历序列一样.
图不连通时, 对每个连通分量各长出一棵 DFS 树, 这些树合起来叫深度优先生成森林. 有向图里从某点出发未必能到所有顶点, 一次 DFS 只覆盖「从该点可达」的部分, 要从每个未访问顶点再出发, 同样得到森林.
广度优先搜索
广度优先搜索 (Breadth-First Search, BFS) 类似二叉树的层次遍历: 从起点出发, 先访问所有距离为 \(1\) 的顶点, 再访问距离为 \(2\) 的, 一层一层往外扩. 实现上靠队列的先进先出 (FIFO): 早发现的顶点早展开, 所以不会出现 DFS 那种「一条路走到底再回头」.
图有环, 同样必须 visited[] (迷宫里用 2 覆盖). 标记应在入队时就做, 否则同一顶点会被多次入队.
算法思想
从任意顶点 \(v\) 出发:
-
访问 \(v\), 标记, 入队
-
队头出队, 把它尚未访问的邻接点依次访问、标记、入队
-
重复直到队列为空. 队列里始终是「当前前线」: 已发现但还没展开邻居的顶点
-
图不连通时, 对每个尚未访问的顶点再调一次 BFS
迷宫模型
普通队列实现
还是同一张迷宫. DFS 使用栈往深处钻; BFS 则使用队列, 四个方向轮流往前走一步, 像把前线整体推出去.
struct point {
    int row, col, predecessor;
} queue[18];
int head = 0, tail = 0;

void visit(int row, int col, int maze[MAX_ROW][MAX_COL])
{
    /* 访问当前点: 记录当前点的坐标和前驱(前驱在队列中的下标) */
    struct point visit_point = { row, col, head - 1 };
    /* 将当前点标记为已访问 */
    maze[row][col] = 2;
    /* 将当前点加入队列 */
    enqueue(visit_point);
}
predecessor 存的是前驱在 queue[] 里的下标:
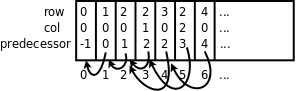
这套数组只往 tail 方向追加, 出队只动 head, 旧元素还在, 所以下标一直有效.
Review
基于栈和队列的性质, 队列的入队操作和出队操作分别位于线性表的两侧, 而栈的出入操作都被限制在栈顶, 因此DFS 的栈弹出后槽位会被下次压栈操作覆盖, 不能采用BFS中「下标当指针指向前驱」的做法.
主循环和 DFS 迭代版几乎采用同一骨架, 只是把栈换成队列:
int bfs_traverse(int maze[MAX_ROW][MAX_COL])
{
    struct point p = { 0, 0, -1 };

    maze[p.row][p.col] = 2;
    enqueue(p);

    while (!is_empty()) {
        p = dequeue();
        if (p.row == MAX_ROW - 1 && p.col == MAX_COL - 1)
            break;
        if (p.col + 1 < MAX_COL && maze[p.row][p.col + 1] == 0)
            visit(p.row, p.col + 1, maze);
        if (p.row + 1 < MAX_ROW && maze[p.row + 1][p.col] == 0)
            visit(p.row + 1, p.col, maze);
        if (p.col - 1 >= 0 && maze[p.row][p.col - 1] == 0)
            visit(p.row, p.col - 1, maze);
        if (p.row - 1 >= 0 && maze[p.row - 1][p.col] == 0)
            visit(p.row - 1, p.col, maze);
    }
    if (p.row == MAX_ROW - 1 && p.col == MAX_COL - 1) {
        printf("(%d, %d)\n", p.row, p.col);
        while (p.predecessor != -1) {
            p = queue[p.predecessor];
            printf("(%d, %d)\n", p.row, p.col);
        }
        return 1;
    }
    return 0;
}
抹去细节:
/* 将起点标记为已走过并入队; */
while (/* 队列非空 */) {
    /* 出队格子 p; */
    if (/* p 是终点 */) break;
    /* 按右 / 下 / 左 / 上: 可走且未走过则标记, 记下前驱, 入队; */
}
同一迷宫上, DFS 可能走出一条绕路, BFS 则可以直接找到边数最少的那条路径, 即可以用于求解单源最短路径.
队列的大小边界
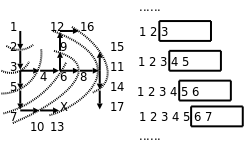
左图按层往外扩, 虚线是搜索波前; 右图对应这份实现里的 queue[]: 只往 tail 追加, 出队只动 head, 已经出队的 1, 2, 3, ... 仍占着槽位. 数组长度因此要按入过队的顶点个数来开, 不是按「同时在队里有几个」.
上面的 5×5 迷宫有 18 个通路格, 从 (0,0) 搜到 (4,4) 时这 18 格全部会入队, 所以 queue[18] 刚好够, 再小一格就会在最后一次 enqueue 越界. 同一趟里 tail - head 最大只有 4, 但那是前线宽度2, 和用于存储队列的数组的宽度 18 不是一回事.
改成循环队列可以让工作队列按前线宽度复用槽位, 但这张迷宫上省下的只是队列本身. predecessor 是数组下标, 槽位一复用就指向别人, 还原 s-t 路径还要把前驱另存, 合计仍是 \(O(|V|)\). 最坏一层就能把队列填满 (起点连着其余所有顶点), 环形队列也改不了这个渐进界.
也不能做成递归 DFS 那种边走边从调用栈上读路径: 递归栈上是当前这一条路, BFS 队列上是一层前线, 同时挂着多条候选. 入队时 print_maze 打的是遍历过程, 不是起点到终点那条路.
当然, 如果只需要知道迷宫是否有通路, 不需要还原路径, 那么就可以使用循环队列来优化空间了:
循环队列实现
上面的 queue[18] 同时存储了前线和历史路径. 若只要是否找到路径, 历史可以扔: maze[][] 的 2 已经是 visited, 本身就已经存储了访问信息(只是结束后已是满图的 2 不便于回溯), 队列里只留「已发现但还没展开」的格子.
这张迷宫前线最宽 \(4\) (即最多同时有 \(4\) 个格子已发现但未访问), 用循环队列, circular_queue[5] (留一个空格用于判空/满)就够用了.
入队 / 出队按模%回绕:
void circular_enqueue(struct point p)
{
    if ((circular_tail + 1) % CIRCULAR_QUEUE_SIZE == circular_head)
        return; /* 队满, 不要再写 */
    circular_queue[circular_tail] = p;
    circular_tail = (circular_tail + 1) % CIRCULAR_QUEUE_SIZE;
}

struct point circular_dequeue(void)
{
    struct point p = circular_queue[circular_head]; /* 先读队头 */
    circular_head = (circular_head + 1) % CIRCULAR_QUEUE_SIZE;
    return p;
}
主循环骨架和普通队列相同, 找到终点就停, 但这时while (p.predecessor != -1)的回溯就是回溯滚木了(如果没有专门开个前驱表的话), 所以没必要再保留:
int bfs_traverse_based_circular(int maze[MAX_ROW][MAX_COL])
{
    struct point p = { 0, 0, -1 };

    maze[p.row][p.col] = 2;
    circular_enqueue(p);

    while (!is_circular_queue_empty()) {
        p = circular_dequeue();
        if (p.row == MAX_ROW - 1 && p.col == MAX_COL - 1)
            break;
        /* 右 / 下 / 左 / 上: 可走则标记并入队 */
    }
    return (p.row == MAX_ROW - 1 && p.col == MAX_COL - 1);
}
抹去细节:
/* 起点标记并入队; */
while (/* 循环队列非空 */) {
    /* 出队格子 p; */
    if (/* p 是终点 */) break;
    /* 按右 / 下 / 左 / 上: 可走且未走过则标记, 入队; */
}
/* 当前格是终点则有路; */
出队要先读再移
若先 head = (head+1) % n 再读 queue[head], 起点在下标 0 会被跳过. 全局数组空槽是 {0,0,0}, 看起来像 (0,0), 但 head 已经等于 tail, 循环一次都跑不完, 直接 No path!. 正确顺序是先取 queue[head], 再把 head 按模加一.
Review
先 maze[row][col] = 2 再入队: 队满时格子被标记却没进队, 等于丢掉; 队满后如果仍往 tail 写, 还会盖掉队头. 应入队成功再标记, 满了就不要写. circular_head - 1 在 head == 0 时是 -1, 没有按模回绕, 循环版本来也不该再用下标当指针.
循环队列只压缩「同时在队里」的那一截. 最坏一层仍是 \(O(|V|)\).
基于图的 BFS 抽象
还是上面那张无向图, 从 \(1\) 出发, 邻接点按编号从小到大. 队列变化:
访问 1, 入队 [1]
出队 1, 邻接 2, 3     队列 [2, 3]
出队 2, 邻接 4, 5     队列 [3, 4, 5]
出队 3, 5 已访
出队 4
出队 5
序列: 1, 2, 3, 4, 5
层号就是到起点的边数: \(\{1\}\) 是第 \(0\) 层, \(\{2,3\}\) 第 \(1\) 层, \(\{4,5\}\) 第 \(2\) 层.
408中习惯同样用 FirstNeighbor / NextNeighbor:
bool visited[MAX_VERTEX_NUM];

void BFS(Graph G, int v)
{
    InitQueue(Q);
    visit(v);
    visited[v] = true;
    EnQueue(Q, v);
    while (!isEmpty(Q)) {
        DeQueue(Q, v);
        for (int w = FirstNeighbor(G, v); w >= 0; w = NextNeighbor(G, v, w))
            if (!visited[w]) {
                visit(w);
                visited[w] = true;
                EnQueue(Q, w);
            }
    }
}

void BFSTraverse(Graph G)
{
    for (int i = 0; i < G.vexnum; ++i)
        visited[i] = false;
    InitQueue(Q);
    for (int i = 0; i < G.vexnum; ++i)
        if (!visited[i])
            BFS(G, i);
}
无向图里调用 BFS 的次数等于连通分量个数, 和 DFS 一样.
性能分析
时间复杂度和 DFS 同理: 每个顶点进一次队, 每条边检查常数次.
| 存储 | 找一个顶点的全部邻接点 | 整图 BFS |
|---|---|---|
| 邻接矩阵 | 扫一行 \(O(\|V\|)\) | \(O(\|V\|^2)\) |
| 邻接表 | 跟边走 \(O(\deg(v))\) | \(O(\|V\| + \|E\|)\) |
空间复杂度: visited[] 为 \(O(|V|)\); 辅助队列最坏 \(O(|V|)\) (起点连着其余所有顶点时, 第一层就把队列填满). 合计仍 \(O(|V|)\).
序列唯一性也和 DFS 同理: 邻接矩阵给定起点后唯一; 邻接表随边表次序而变, 题目画出了具体邻接表则以该表为准.
求解单源最短路径问题
设边权都是 \(1\) (或根本无权). BFS第一次到达某个顶点时, 走过的边数就是起点到它的最少边数.
直觉
队列按发现先后排列, 先出队的层号更小; 若存在更短的路, 那个顶点本应在更早的层被发现.
迷宫里格子到格子一步算一条边, 所以 BFS 找到的是步数最少的路, DFS 不保证. 这只对无权 / 等权成立. 边权是任意正数时改用Dijkstra; 有负权更不能用 BFS.
求的是一个起点到其余顶点的距离, 所以叫单源最短路径. 把各层顶点记下来, 层号就是距离; 前驱 (树边的父亲) 用来还原路径, 和迷宫里倒着打印是同一件事.
还原路径
把各层顶点记下来, 层号就是距离; 前驱 (树边的父亲) 用来还原路径, 和迷宫里倒着打印是同一件事.
广度优先生成树
BFS 中第一次走到尚未访问的 \(w\) 时, 边 \((v, w)\) 是树边. 全部树边构成一棵生成树. 上面序列 \(1,2,3,4,5\) 对应树边 \(1{-}2\), \(1{-}3\), \(2{-}4\), \(2{-}5\):
      1
     / \
    2   3
   / \
  4   5
\(3{-}5\) 连到同层或已访问的点, 不是树边. BFS 树往往又矮又宽 (按层铺); DFS 树往往又高又瘦. 二者都是生成树, 却都不是最小生成树.
邻接表不唯一时, 广度优先生成树也不唯一. 图不连通则每个连通分量一棵 BFS 树, 合称广度优先生成森林.
| DFS | BFS | |
|---|---|---|
| 辅助结构 | 栈 (递归或显式) | 队列 |
| 访问顺序 | 一条路走到底再回溯 | 按到起点的远近分层 |
| 无权最短路 | 不保证 | 第一次到达即最短 |
| 生成树形状 | 偏高瘦 | 偏矮宽 |
| 时间 / 空间 | 同阶, 见上表 | 同阶, 见上表 |