图的存储及基本操作
图的存储要把顶点集 \(V\) 和边集 \(E\)都记录下来. 选哪种结构, 看图是稠密还是稀疏, 以及后面算法更常查「两点有没有边」还是「某个点的全部邻接点」.
| 邻接矩阵 | 邻接表 | 十字链表 | 邻接多重表 | |
|---|---|---|---|---|
| 空间 | \(O(\|V\|^2)\) | 无向: \(O(\|V\| + 2\|E\|)\) 有向: \(O(\|V\| + \|E\|)\) | \(O(\|V\| + \|E\|)\) | \(O(\|V\| + \|E\|)\) |
| 找相邻边 | 扫一行或一列, \(O(\|V\|)\) | 出边方便; 有向图入边要扫全表 | 出入边都方便 | 方便 |
| 删边 / 删顶点 | 删边 \(O(1)\); 删顶点要挪矩阵 | 无向图两边都要改, 不方便 | 方便 | 方便 (边只存一份) |
| 适用 | 稠密图 | 稀疏图 | 只存有向图 | 只存无向图 |
| 表示是否唯一 | 唯一 | 不唯一 | 不唯一 | 不唯一 |
邻接矩阵
用一个一维数组存顶点, 一个二维数组存边. 后者就叫邻接矩阵 (Adjacency Matrix).
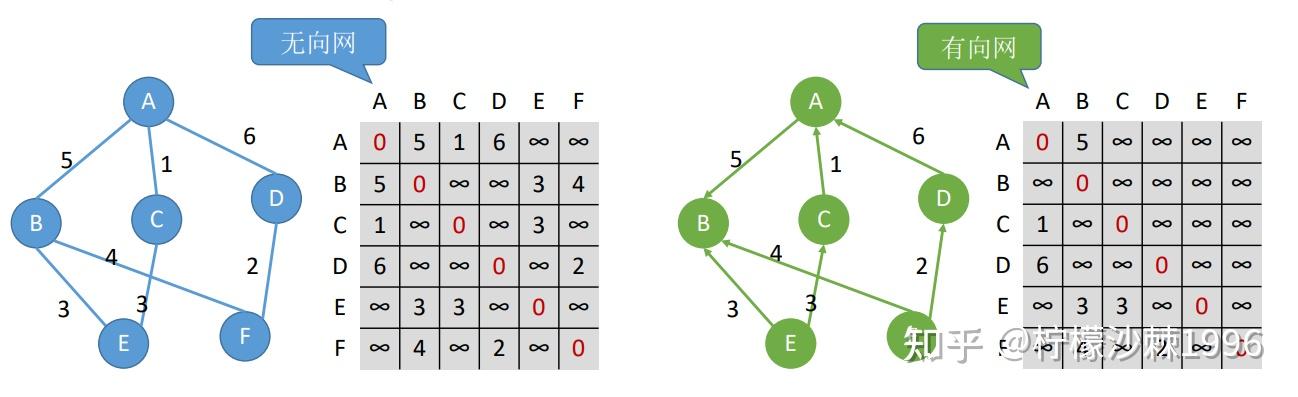
\(n\) 个顶点编号 \(0..n-1\) (或 \(1..n\)), 矩阵 \(A\) 是 \(n \times n\):
简单图没有自环, 对角线全是 \(0\).
#define MaxVertexNum 100

typedef char VertexType;
typedef int EdgeType;

typedef struct {
    VertexType Vex[MaxVertexNum];
    EdgeType Edge[MaxVertexNum][MaxVertexNum];
    int vexnum, arcnum;
} MGraph;
若图的规模较小, 可以直接拿二维数组当图, 顶点信息可以省略.
有向图与无向图
有向图 \(G_1\) (\(1 \leftrightarrow 2 \rightarrow 3\)):
      1  2  3
   1  0  1  0
   2  1  0  1
   3  0  0  0
\(A[i][j] = 1\) 表示有弧 \(\langle i, j \rangle\), 和 \(A[j][i]\) 无关.
无向图 \(G_2\) 是 \(4\) 阶完全图:
      1  2  3  4
   1  0  1  1  1
   2  1  0  1  1
   3  1  1  0  1
   4  1  1  1  0
无向边 \((i, j)\) 要在 \(A[i][j]\) 和 \(A[j][i]\) 各记一次, 所以无向图的邻接矩阵一定对称, 且给定顶点编号后表示唯一. 大矩阵可以按对称矩阵只存上三角或下三角.
度、出度、入度
扫一行或一列非零 (带权图则非 \(0\)、非 \(\infty\)) 的个数, 时间 \(O(|V|)\):
-
无向图: 第 \(i\) 行 (或列) 的非零个数 \(= TD(v_i)\)
-
有向图: 第 \(i\) 行 \(= OD(v_i)\), 第 \(i\) 列 \(= ID(v_i)\), 度是二者之和
\(G_1\) 里顶点 \(2\): 第 \(2\) 行两个 \(1\) (出度 \(2\)), 第 \(2\) 列一个 \(1\) (入度 \(1\)), 与基本概念一致.
查「\(i\) 和 \(j\) 有没有边」直接读 \(A[i][j]\), \(O(1)\). 数一共有多少条边, 却要扫完整张矩阵.
带权图
把 \(1/0\) 换成权值. 没有边记一个很大的数 \(\infty\) (代码里常用 INT_MAX 或 0x3f3f3f3f), 自身到自身通常记 \(0\):
Dijkstra / Floyd两个算法都基于这个模型工作.
性能与 \(A^n\)
空间复杂度 \(O(|V|^2)\), 只跟顶点数有关, 跟边数无关, 所以适合稠密图. 稀疏图会出现大量 \(0\) 从而导致空间浪费.
设无权图的邻接矩阵为 \(A\) (元素 \(0/1\)), 则 \((A^n)[i][j]\) 等于 \(i\) 到 \(j\) 长度为 \(n\) 的路径条数. \(A^2[i][j] = \sum_k A[i][k]A[k][j]\), 每个公共邻接点贡献一条长为 \(2\) 的路.
邻接表
邻接矩阵在稀疏图上太空, 浪费空间. 邻接表(Adjacency List) 改成: 顶点表用顺序表, 每个顶点挂一条单链表记下它的邻接点. 和树的孩子表示法同一思路.
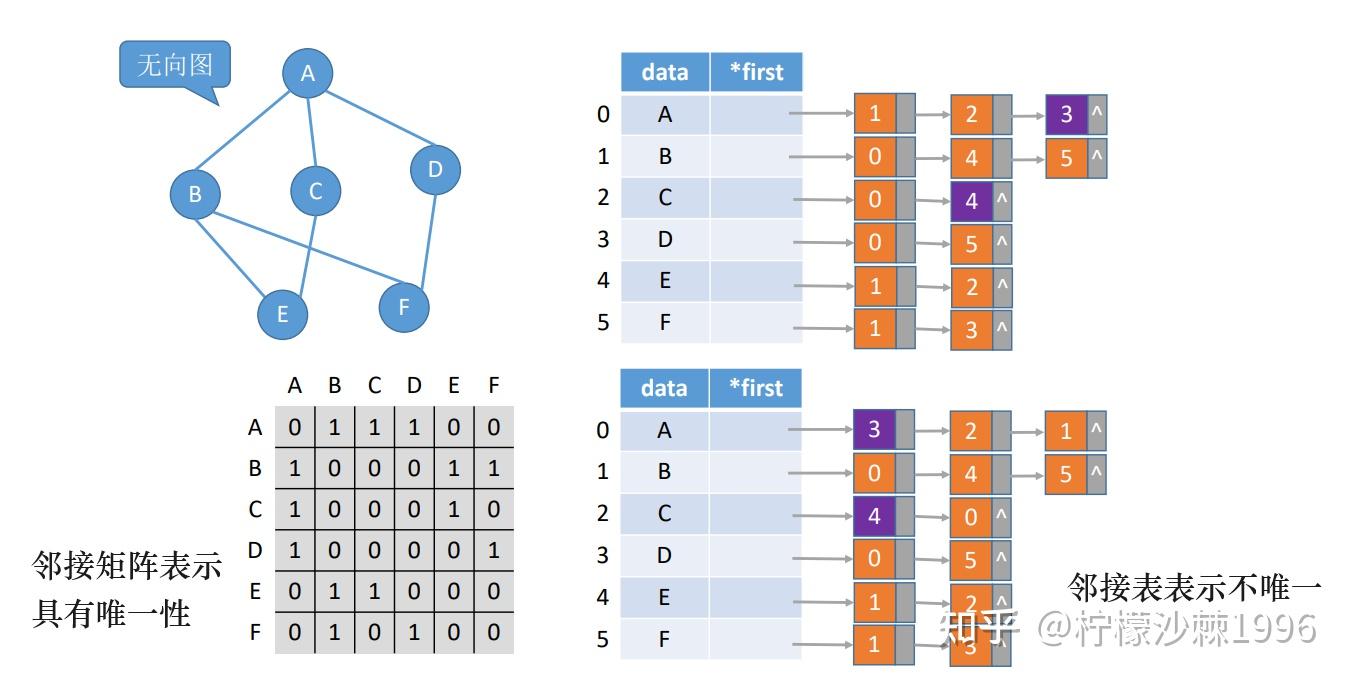
typedef struct ArcNode {
    int adjvex;              // 邻接点编号
    struct ArcNode *next;
    // InfoType info;        // 带权时加权值
} ArcNode;

typedef struct VNode {
    VertexType data;
    ArcNode *first;
} VNode, AdjList[MaxVertexNum];

typedef struct {
    AdjList vertices;
    int vexnum, arcnum;
} ALGraph;
\(G_1\) 的邻接表 (边表次序随输入而变, 这里按编号从小到大):
1 → 2
2 → 1 → 3
3 → (空)
无向图每条边在两个顶点的边表里各出现一次. \(G_2\) 每个顶点的边表长度都是 \(3\).
空间与度
-
无向图: 边结点 \(2|E|\) 个, 空间 \(O(|V| + 2|E|)\)
-
有向图: 边结点 \(|E|\) 个 (只记出弧), 空间 \(O(|V| + |E|)\)
求度:
-
无向图 / 有向图出度: 数该顶点边表长度即可
-
有向图入度: 要扫所有顶点的边表, 统计
adjvex == x的结点, \(O(|V| + |E|)\)
只存出弧时, 找入边不方便. 可以再为每个顶点建一张逆邻接表 (入边表). 十字链表等于把邻接表和逆邻接表合在一套结点上.
给定顶点, 枚举邻接点只要顺着边表走, 比扫矩阵一整行便宜; 判断 \(x\) 和 \(y\) 有没有边, 却要在 \(x\) 的边表里找 \(y\), 最坏 \(O(\deg(x))\).
表示不唯一
边表结点的链接次序取决于建表算法和边的输入顺序, 所以邻接表不唯一. 这就是DFS / BFS 序列在邻接表下一般不唯一、在邻接矩阵下唯一的原因. 题目若画出了具体邻接表, 按该表执行即可.
十字链表
十字链表 (Orthogonal List) 只用于有向图: 每条弧一个结点, 弧头相同的弧串成一条链, 弧尾相同的弧串成另一条, 顶点和顶点仍顺序存放.
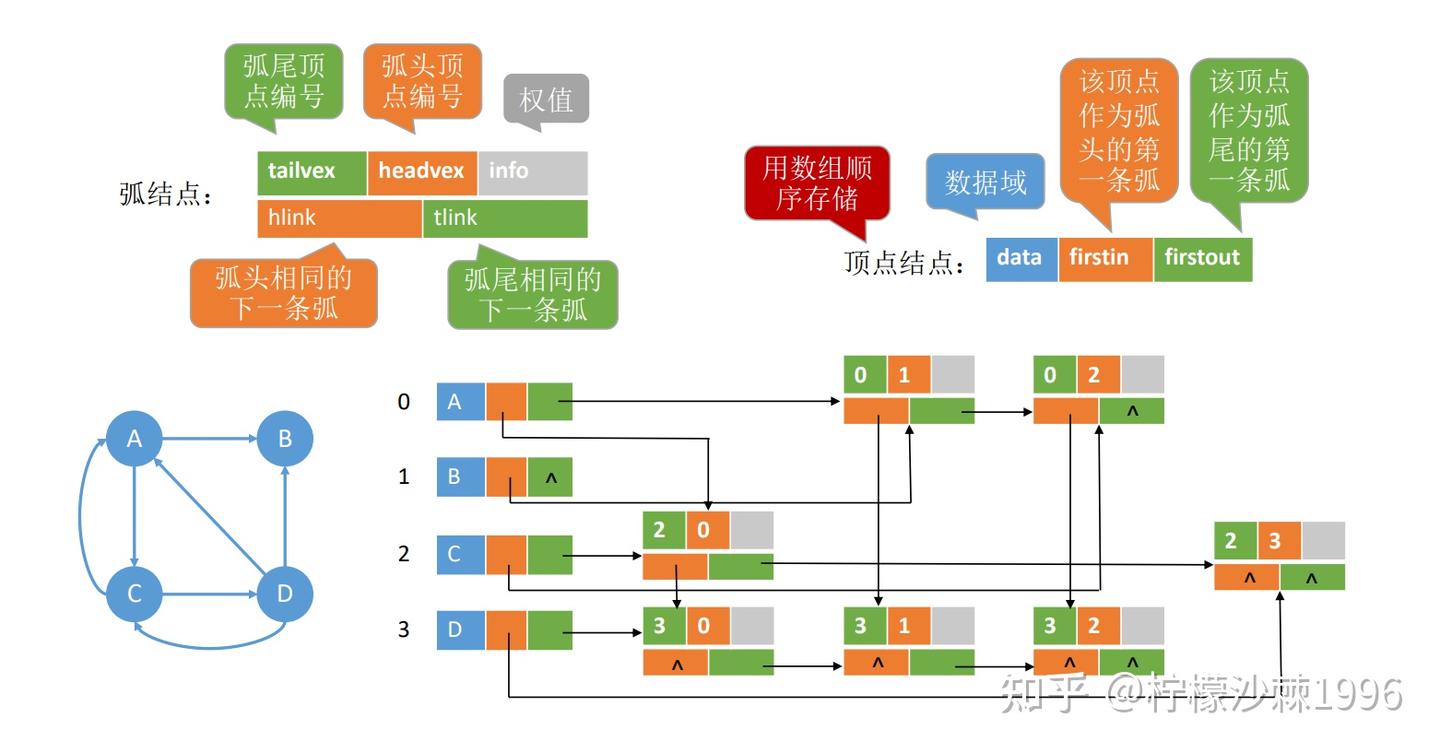
弧结点:
tailvex | headvex | hlink | tlink | info |
|---|---|---|---|---|
| 弧尾编号 | 弧头编号 | 同弧头的下一条弧 | 同弧尾的下一条弧 | 权值等 |
顶点结点:
data | firstin | firstout |
|---|---|---|
| 顶点信息 | 以它为弧头的第一条弧 | 以它为弧尾的第一条弧 |
typedef struct ArcBox {
    int tailvex, headvex;
    struct ArcBox *hlink, *tlink;
    // InfoType info;
} ArcBox;

typedef struct VexNode {
    VertexType data;
    ArcBox *firstin, *firstout;
} VexNode;

typedef struct {
    VexNode xlist[MaxVertexNum];
    int vexnum, arcnum;
} OLGraph;
对 \(G_1\): 顶点 \(2\) 的 firstout 沿 tlink 走出弧 \(\langle 2,1 \rangle\), \(\langle 2,3 \rangle\); firstin 沿 hlink 走入弧 \(\langle 1,2 \rangle\). 出度、入度都只要顺着对应链数结点, 不必像邻接表那样为入度扫全图.
空间 \(O(|V| + |E|)\) (弧只存一份). 链的衔接次序可变, 表示不唯一; 一个十字链表却唯一确定一张有向图.
邻接多重表
邻接多重表 (Adjacency Multilist) 只用于无向图. 邻接表里一条无向边要写两个边结点, 删边就得改两处. 多重表让每条边只占一个结点, 同时挂在两个顶点的边链上.
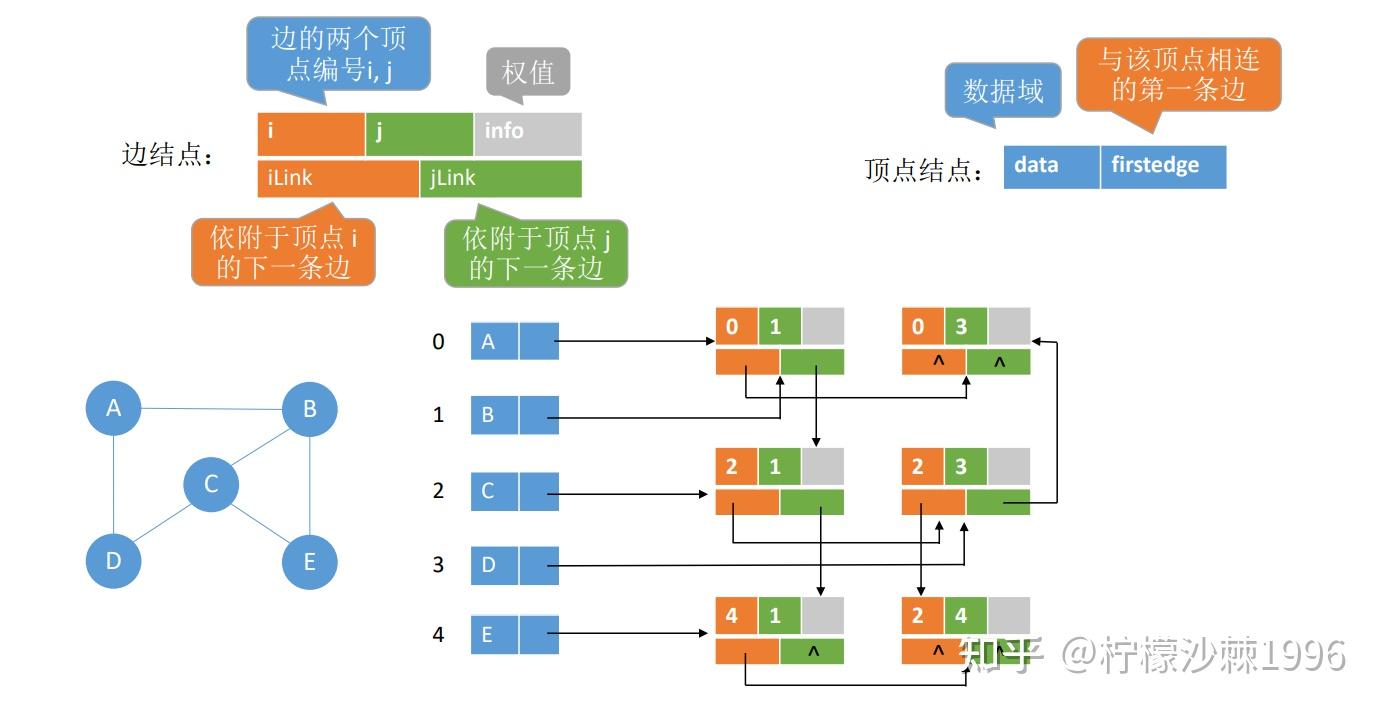
边结点:
mark | ivex | ilink | jvex | jlink | info |
|---|---|---|---|---|---|
| 是否访问过 (可选) | 顶点 \(i\) | 依附 \(i\) 的下一条边 | 顶点 \(j\) | 依附 \(j\) 的下一条边 | 权值等 |
顶点结点: data + firstedge (第一条依附它的边).
typedef struct EBox {
    int ivex, jvex;
    struct EBox *ilink, *jlink;
    // int mark;
    // InfoType info;
} EBox;

typedef struct {
    VertexType data;
    EBox *firstedge;
} VexBox;

typedef struct {
    VexBox adjmulist[MaxVertexNum];
    int vexnum, edgenum;
} AMLGraph;
以 \(G_2\) 的一棵生成树 \((1{-}2),\ (1{-}3),\ (1{-}4)\) 为例: 三条边各一个结点, 顶点 \(1\) 的 firstedge 指向其中一条, 再沿 ilink (若该边的 \(i\) 端是 \(1\)) 串起另外两条. 删掉边 \((1,2)\) 时, 把顶点 \(1\) 和顶点 \(2\) 上指向它的指针改接到它的 ilink / jlink, 再释放该结点即可, 不必再跑到另一张边表里找副本.
空间 \(O(|V| + |E|)\), 边无冗余. 表示同样不唯一.
应试记忆
考试大头是邻接矩阵和邻接表. 十字链表 = 有向图的「出边表 + 入边表」; 邻接多重表 = 无向图里「边只存一次」. 看到「既要说出度又要说入度」想十字链表, 看到「无向图频繁删边」想邻接多重表.
图的基本操作
操作定义与存储无关, 复杂度随存储而变. 图的大部分操作是为其遍历服务的.
408遍历代码里最常调用的是 FirstNeighbor / NextNeighbor.
| 操作 | 含义 | 邻接矩阵 | 邻接表 |
|---|---|---|---|
Adjacent(G,x,y) | 是否存在边 \((x,y)\) 或 \(\langle x,y \rangle\) | 读 \(A[x][y]\), \(O(1)\) | 在 \(x\) 的边表里找 \(y\), \(O(\deg(x))\) |
Neighbors(G,x) | 列出 \(x\) 的邻接边 | 扫第 \(x\) 行, \(O(\|V\|)\) | 走 \(x\) 的边表; 有向图入边要扫全表 \(O(\|E\|)\) |
InsertVertex(G,x) | 插入顶点 | 顶点表末尾写入, \(O(1)\) (矩阵预留了空行) | 顶点表末尾加空边表, \(O(1)\) |
DeleteVertex(G,x) | 删除顶点及关联边 | 朴素做法要压缩行列 \(O(\|V\|^2)\); 惰性删除 (标记 + 清行/列) \(O(\|V\|)\) | 还要在其他边表里摘掉指向 \(x\) 的结点, 最坏 \(O(\|E\|)\) |
AddEdge(G,x,y) | 加边 (无则加) | 置 \(A[x][y]\) (无向再置 \(A[y][x]\)), \(O(1)\) | 头插 \(O(1)\); 若先查重则 \(O(\deg(x))\) |
RemoveEdge(G,x,y) | 删边 (有则删) | 置 \(0\), \(O(1)\) | 在边表里摘结点, \(O(\deg(x))\) |
Get/Set_edge_value | 读写权值 | 同 Adjacent, \(O(1)\) | 同 Adjacent |
十字链表 / 邻接多重表上, 找出入边、删边都顺着链改指针, 比邻接表省「改两份」的麻烦.
FirstNeighbor 与 NextNeighbor
FirstNeighbor(G, x): 返回 \(x\) 的第一个邻接点编号; \(x\) 不存在或没有邻接点则 \(-1\).
NextNeighbor(G, x, y): 已知 \(y\) 是 \(x\) 的一个邻接点, 返回 \(x\) 的下一个邻接点; \(y\) 已是最后一个则 \(-1\).
DFS 里枚举邻接点就是:
for (int w = FirstNeighbor(G, v); w >= 0; w = NextNeighbor(G, v, w))
    ...
基于邻接矩阵
从第 \(x\) 行下标 \(0\) (或 \(y+1\)) 起往后扫第一个非零元, 最坏 \(O(|V|)\). 有向图若要找「指向 \(x\) 的点」, 改扫第 \(x\) 列.
int FirstNeighbor(MGraph G, int x) {
    for (int j = 0; j < G.vexnum; ++j)
        if (G.Edge[x][j])          // 带权则还要排除 INF
            return j;
    return -1;
}

int NextNeighbor(MGraph G, int x, int y) {
    for (int j = y + 1; j < G.vexnum; ++j)
        if (G.Edge[x][j])
            return j;
    return -1;
}
基于邻接表
第一个邻接点是边表头, 下一个是当前结点的 next. 遍历时顺着指针走, 都是 \(O(1)\); 若每次从链表头重新找 \(y\), NextNeighbor 会退化成 \(O(\deg(x))\). 有向图的入边第一个邻接点仍要扫全表.
int FirstNeighbor(ALGraph G, int x) {
    if (G.vertices[x].first == NULL)
        return -1;
    return G.vertices[x].first->adjvex;
}

int NextNeighbor(ALGraph G, int x, int y) {
    ArcNode *p = G.vertices[x].first;
    while (p && p->adjvex != y)
        p = p->next;
    if (p && p->next)
        return p->next->adjvex;
    return -1;
}