minirv32处理器
minirv32 ISA
一生一芯 F6 从 RV32I 中抽出8条指令,组成迷你指令集minirv。用它们组合即可模拟其余 RV32I 功能,从而不必一次实现完整的四十多条指令。
在实现前,需要先明确计算机各个部件的规格与约定,以及指令集的编码规则。
除下面出现的特别约定外,其余细节与 RV32I 相同(定长 32 位指令、字节编址、立即数符号扩展、x0 恒为 0 等)。完整的 RV32I ISA 可参考RV32I Reference Card。
PC
-
位宽 32 bit(与 RV32I 的 XLEN 一致),按字节地址计数。
-
初值为
0。 -
顺序执行时每次
PC ← PC + 4(一条指令占 4 字节);jalr会改写 PC。
GPR
-
每个寄存器的数据位宽为 32 bit。
-
ISA 的
rd/rs1/rs2字段仍是 5 bit (inst[11:7]等), 但堆里只有 16 个寄存器, 电路只取低 4 bit 接到 GPRs. 这是 RV32E 的有意截断, 不是译码漏线.软件侧必须用 RV32E 工具链 (
-march=rv32e -mabi=ilp32e), 保证汇编器不会排出x16--x31. 若误用 RV32I,x16的最高位被丢掉后会别名成x0, 写入被硬接线吞掉, 看起来像"指令没生效".硬件上不必把寄存器扩到 32 个. 若想防呆, 可以把丢掉的那一位置 1 时强制
we=0(写) 或当x0读, 当作非法寄存器号; 正常 minirv 程序用不到.
支持的指令
接下来的设计将支持以下 8 种指令:
31         25 24    20 19   15 14    12 11        7 6        0
+------------+--------+-------+--------+-----------+----------+
|  0000000   |  rs2   |  rs1  |  000   |    rd     | 0110011  |  add   R[rd]=R[rs1]+R[rs2]
+------------+--------+-------+--------+-----------+----------+
|      imm[11:0]      |  rs1  |  000   |    rd     | 0010011  |  addi  R[rd]=R[rs1]+imm
+------------+--------+-------+--------+-----------+----------+
|              imm[31:12]              |    rd     | 0110111  |  lui   R[rd]=imm<<12
+--------------------------------------+-----------+----------+
|      imm[11:0]      |  rs1  |  010   |    rd     | 0000011  |  lw    R[rd]=M[R[rs1]+imm]
+------------+--------+-------+--------+-----------+----------+
|      imm[11:0]      |  rs1  |  100   |    rd     | 0000011  |  lbu   zero-ext byte load
+------------+--------+-------+--------+-----------+----------+
| imm[11:5]  |  rs2   |  rs1  |  010   | imm[4:0]  | 0100011  |  sw    M[R[rs1]+imm]=R[rs2]
+------------+--------+-------+--------+-----------+----------+
| imm[11:5]  |  rs2   |  rs1  |  000   | imm[4:0]  | 0100011  |  sb    store low byte
+------------+--------+-------+--------+-----------+----------+
|      imm[11:0]      |  rs1  |  000   |    rd     | 1100111  |  jalr  R[rd]=PC+4; PC=(R[rs1]+imm)&~1
+------------+--------+-------+--------+-----------+----------+
涉及的指令布局类型有:R(add)、I(addi / lw / lbu / jalr)、S(sw / sb)、U(lui)。格式总览见 Instruction Format by Type。
算术运算指令
| Instruction | Description | Type | Opcode | funct3 | funct7 |
|---|---|---|---|---|---|
add rd, rs1, rs2 | R[rd] = R[rs1] + R[rs2] | R | 0110011 | 000 | 0000000 |
addi rd, rs1, imm | R[rd] = R[rs1] + imm(imm 符号扩展) | I | 0010011 | 000 | — |
lui rd, imm | R[rd] = imm << 12(低 12 位清零) | U | 0110111 | — | — |
addi 可配合 x0 装小立即数;大常数常用 lui + addi 拼出。
加载-存储指令
实际就是操作内存的指令,之所以称之为加载-存储指令,是因为RISC-V采用加载-存储架构,只有load和store指令可以访问内存,ALU指令只能访问寄存器。
| Instruction | Description | Type | Opcode | funct3 |
|---|---|---|---|---|
lw rd, imm(rs1) | 读字:R[rd] = M[R[rs1]+imm][31:0] | I | 0000011 | 010 |
lbu rd, imm(rs1) | 读字节并零扩展到 32 位 | I | 0000011 | 100 |
sw rs2, imm(rs1) | 写字:M[R[rs1]+imm] = R[rs2] | S | 0100011 | 010 |
sb rs2, imm(rs1) | 写字节:只更新目标字中的对应字节 | S | 0100011 | 000 |
控制指令
minirv32只实现一条控制流指令,用于间接跳转(也可做函数返回:jalr x0, ra, 0)。
| Instruction | Description | Type | Opcode | funct3 |
|---|---|---|---|---|
jalr rd, rs1, imm | R[rd] = PC+4;PC = (R[rs1]+imm) & ~1 | I | 1100111 | 000 |
jalr指令的控制原理
顺序执行时 CPU 每拍只做 PC ← PC + 4. jalr 要把这条默认路径打断, 同时做两件事:
-
留下回家的路: 把本条指令的下一条地址
PC+4写入rd(常选ra). 子程序结束时再用jalr x0, ra, 0跳回来. 若rd是x0, 链接被丢掉, 相当于只跳不记 (如停机环jalr zero, 12(zero)). -
改下一条从哪取指: 新 PC 不是
PC+4, 而是寄存器里的地址再加立即数:R[rs1] + imm. 这叫间接跳转: 目标可以来自ra, 也可以是zero + 立即数这种绝对地址.
写入 PC 前还要执行 ... & ~1:
-
~(按位取反):1只有最低位是 1,~1变成「最低位为 0, 其余为 1」的掩码 (32 位即0xFFFFFFFE). -
&(按位与): 两位都是 1 结果才是 1. 于是x & ~1只把x的最低位清成 0, 高位原样保留.
目的是保证跳转目标是偶数地址. RISC-V 指令至少按 2 字节对齐, 奇数地址无法正确取指; 规范要求硬件在 jalr 时强制对齐, 即使 R[rs1]+imm 算出来是奇数. minirv32 只有 4 字节定长指令, 合法目标通常已是 4 的倍数, 但仍按完整 RV32I 语义清 bit 0.
从电路视角来看就是: 译码认出 jalr 后, PC 的下一地址改选 (R[rs1]+imm) & ~1, 写回 GPR 的数据改选 PC+4.
ROM
存放指令的只读存储器(Read-Only Memory),供取指使用。相对 sCPU 里 \(16\times 8\) 的指令 ROM,这里要换成能装下 32 位 RISC-V 指令的规格。
-
数据位宽 32 bit
-
ROM 的地址位宽应按实际需要的指令条数(深度)来选即可,做成 32 意味着约 \(2^{32}\) 个字,仿真里既不现实(Logisim只支持最大24位的地址位宽)也无必要。
-
行大小:单行
-
是否允许未对齐:否
RAM
minirv32的lw、lbu、sw、sb指令都访问它;只有取指用ROM不够,因为store指令包含写入操作。
-
数据位宽 32 bit(一个字);ISA 仍按字节编址,故
lbu、sb要在字内选出正确字节。 -
地址抽象:与 ROM 一样,ISA 给出的是字节地址
R[rs1]+imm。RAM 数据口是 32 位时,字地址应取addr[17:2](即addr >> 2),低 2 位留给字节选择,不应把addr[15:0]直接当字地址。 -
启用方式:使用字节启用(4bit对应字里4个字节)
-
RAM型:非易失性
-
使用清除销:否
-
触发器:上升沿
-
异步读取:是
-
读写控制:使用字节启用(不要再用单根 WE)
字节使能
RISC-V 是小端. 一个对齐字
addr[31:2]<<2里, 低地址对应低字节:addr[1:0]字内字节 对应数据位 sb时应拉高的字节使能00第 0 字节 [7:0]000101第 1 字节 [15:8]001010第 2 字节 [23:16]010011第 3 字节 [31:24]1000读和写走两条不同的路, 不要混在一起:
- 数据总线实现:用于读写的独立数据总线
电路实现
取指与PC更新
针对取指和PC更新,本质上无非就是计数器(PC寄存器加加法器)加指令存储器的组合,电路结构可直接参考sCPU。
但这里需要解决一个ISA与电路上的抽象差异:
不同视角下的地址抽象
-
ISA 视角的地址:RISC-V 按字节编址,PC 是 32 位字节地址,理论可覆盖约 \(2^{32}\) 字节(即所谓的4GB地址空间)。顺序下一条指令在
PC+4。 -
电路视角的地址:Logisim 等元件里,若 ROM 数据宽度 = 32,则每个地址对应的是一个字,因此不能把 PC 的 32 位原样当 ROM 地址线,需要进行分线处理。
常见做法是用 PC[31:2](等价于 PC >> 2)做字地址——低 2 位在按字取指时恒为 00。同时 ROM 地址位宽往往远小于 32,只需再截出低若干位接到 ROM。
Example
若ROM的地址位宽为 \(16\),则ROM只能存 \(2^{16}\) 条指令,地址线只要16根;字地址还要丢掉字节地址的最低 2 位。
用分线器(Splitter)从 32 位 PC 上拆出:
| PC 位段 | 位数 | 接到哪里 |
|---|---|---|
PC[1:0] | 2 | 悬空 / 不接(取指对齐时应为 00) |
PC[17:2] | 16 | 接入 ROM 的地址线 A[15:0] |
PC[31:18] | 14 | 悬空 / 不接(当前小 ROM 用不到;程序须装在低地址) |
也就是说 ROM_A = PC[17:2]。等价于先 PC >> 2 得到字地址,再取低 16 位:

ISA手册里的「内存」是字节编址的抽象 \(M[\textit{addr}]\);板上的 ROM/RAM 组件往往按「深度 × 数据宽度」配置。两者对不齐时,就用这种分线 / 截位把 ISA 地址接到电路端口上。
下面在实现时若未对这里的地址抽象有足够充分的理解, 可能就会陷入误区.
ADDI指令
操作码译码
首先观察addi指令的格式:
31         25 24    20 19   15 14    12 11        7 6        0
+------------+--------+-------+--------+-----------+----------+
|      imm[11:0]      |  rs1  |  000   |    rd     | 0010011  |  addi  R[rd]=R[rs1]+imm
+------------+--------+-------+--------+-----------+----------+
显然, 用于标识addi指令的字段有:
-
inst[6:0]的opcode:0x13(0010011) -
inst[14:12]的funct3:000
至于为什么还有个 funct3 字段, 参考RV32I Reference Card 的 Why use multiple fields to encode an instruction?信息栏.
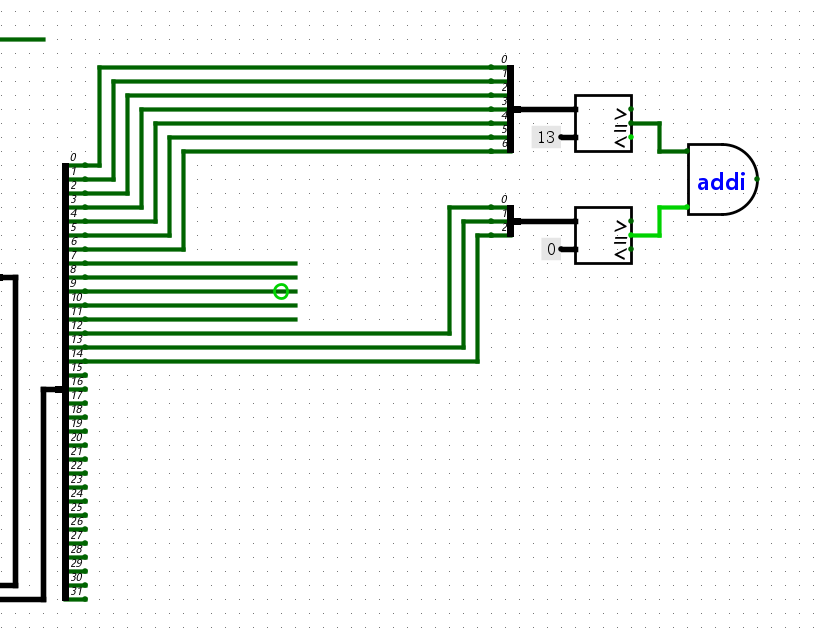
由于minirv32实现的指令只有8种, 操作码编码较为稀疏, 使用译码器反而会带来一些不便. 因此可以考虑直接使用比较器直接比较指令中的操作码字段是否与addi指令的编码一致1:
is_addi = (inst[6:0] == `0x13`) && (inst[14:12] == `0x00`)
操作数译码
在addi指令中, 操作数译码方面主要需要注意的是立即数的位扩展问题:
在约定中我们提到, GPR的数据位宽是32位的, 而addi指令的立即数位宽显然没有这么大, 这时就需要考虑位扩展. 扩展的方式一般有两种:
-
一种是称为零扩展(zero extension), 就是简单粗暴的高位补零, 我们在实现sCPU时就是采用的这种方式.
-
另外一种叫符号扩展(sign extension), 这种方式是在高位添加补码的符号位.
符号扩展的数学原理
符号扩展前后,补码解释下的真值不变。能证明多扩 1 位,即可利用数学归纳法扩展到任意位。
设 \(k\) 位补码
\[ A = (a_{k-1}a_{k-2}\cdots a_0)_2,\qquad [A]_补 = -a_{k-1}\cdot 2^{k-1} + \sum_{i=0}^{k-2} a_i\cdot 2^i. \]符号扩展 1 位:把符号位 \(a_{k-1}\) 再抄一份到最高位,得到 \(k+1\) 位数
\[ A' = (a_{k-1}\,a_{k-1}\,a_{k-2}\cdots a_0)_2. \]-
若 \(a_{k-1}=0\)(非负):高位补的也是
0,加权式不变,显然 \([A']_补=[A]_补\)。 -
若 \(a_{k-1}=1\)(负):
\[ \begin{align} [A]_补 &= -2^{k-1} + \sum_{i=0}^{k-2} a_i\cdot 2^i, \\[0.5em] [A']_补 &= -2^{k} + a_{k-1}\cdot 2^{k-1} + \sum_{i=0}^{k-2} a_i\cdot 2^i \\ &= -2^{k} + 2^{k-1} + \sum_{i=0}^{k-2} a_i\cdot 2^i \quad(a_{k-1}=1) \\ &= -2^{k-1} + \sum_{i=0}^{k-2} a_i\cdot 2^i = [A]_补. \end{align} \]
因此扩 1 位真值不变。对目标宽度反复做「扩 1 位」,由归纳可知扩到任意更长位宽(含 32 位)真值仍不变。
4 位 → 5 位
\(-3\) 的 4 位补码是
1101(\(-8+4+1=-3\))。符号扩展为11101:\[ -16 + 8 + 4 + 1 = -3, \]与扩展前相同。
-
Logisim中自带位扩展器, 可根据配置选择是零扩展还是符号扩展.
测试addi指令时除了下面用到的测试指令外, 还需要考虑立即数是负数的情况, 可以考虑使用以下程序进行测试:
ffa00513  addi a0, zero, -6
00150513  addi a0, a0, 1
00550513  addi a0, a0, 5
这是一个连续加法 \(-6 + 1 + 5 = 0\) 的程序, 测试时应该可以观察到a0的值最终为0.
JALR指令
观察jalr指令的格式:
31         25 24    20 19   15 14    12 11        7 6        0
+------------+--------+-------+--------+-----------+----------+
|      imm[11:0]      |  rs1  |  000   |    rd     | 1100111  |  jalr  R[rd]=PC+4; PC=(R[rs1]+imm)&~1
+------------+--------+-------+--------+-----------+----------+
不难发现其实和addi的指令格式几乎一致, 都是I 型, imm[11:0], rs1, funct3, rd 所在位段相同, 唯一的区别在opcode (addi 为 0010011, jalr 为 1100111).
运算方面, 两条指令对操作数的处理也是一致的:
| 步骤 | addi | jalr |
|---|---|---|
| 读寄存器 | 读 R[rs1] | 读 R[rs1] (同一根 rs1 字段) |
| 立即数 | 取出 imm[11:0] 并符号扩展到 32 位 | 同上 (I 型立即数编码方式相同) |
| ALU | R[rs1] + imm | R[rs1] + imm (跳转目标地址的计算) |
加法器算的都是"基址寄存器 + 符号扩展后的立即数", addi 把和写回 rd; jalr 把和送去更新 PC (再清最低位: & ~1), 同时另需 PC+4 写入 rd 作链接地址. 差异在结果往哪送 (写回 GPR vs 改 PC), 不在操作数怎么算.
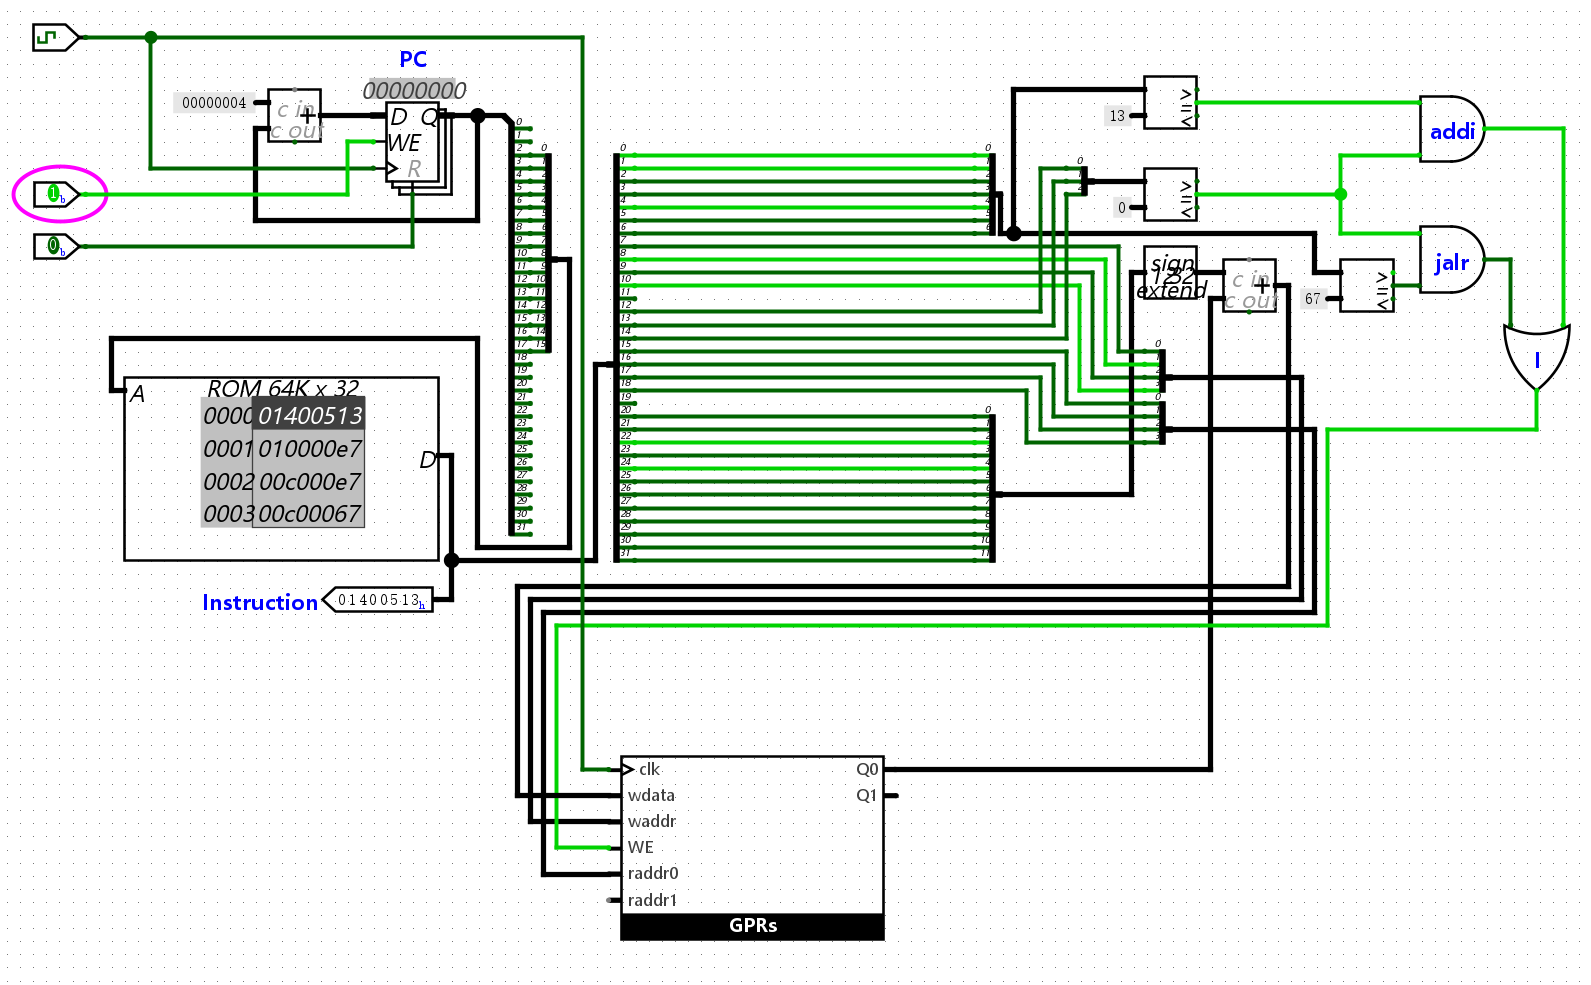
因此前面为 addi 搭好的 rs1 读口, 立即数分线/符号扩展和加法器可以直接复给 jalr; 控制逻辑上只需多识别 opcode, 并在 jalr 时把 ALU 输出接到 PC (而非 GPR 写回), 另用 PC+4 作为 rd 的写回数据.
这意味着我们可以很大程度地复用前面实现 addi 指令时的电路, 只需要在电路上再添加比较 jalr 的 opcode 的逻辑即可, funct3 字段 (同为 000) 也可以直接复用前面的实现:
这时我们已经可以编写一些只基于这两个指令的简单程序进行简单验证了:
00000000 <_start>:
   0:   01400513            addi    a0,zero,20
   4:   010000e7            jalr    ra,16(zero) # 10 <fun>
   8:   00c000e7            jalr    ra,12(zero) # c <halt>

0000000c <halt>:
   c:   00c00067            jalr    zero,12(zero) # c <halt>

00000010 <fun>:
  10:   00a50513            addi    a0,a0,10
  14:   00008067            jalr    zero,0(ra)
字节地址与字地址问题的实例
在取指与PC更新中我们提到, 反汇编 / 文档里的 0, 4, 8, c, 10, 14 是PC 字节地址; Logisim 里数据宽度为 32 的 ROM 却按字编址, 实际取指地址是 ROM_A = PC[17:2] (即 PC >> 2).
因此上面这段程序装进 ROM 时, 应对齐成连续 6 个字, 中间不应按字节地址去留空:
| 文档中的 PC (字节) | ROM 字地址 | 机器码 |
|---|---|---|
0x0 | 0 | 01400513 |
0x4 | 1 | 010000e7 |
0x8 | 2 | 00c000e7 |
0xc | 3 | 00c00067 |
0x10 | 4 | 00a50513 |
0x14 | 5 | 00008067 |
也就是 ROM 内容应类似:
01400513 010000e7 00c000e7 00c00067 00a50513 00008067
初学者在看到文档写 PC=0x4时, 可能会产生误区, 认为应该在 ROM 的下标 0x4 填指令, 并在 0x1..0x3 留空. 那样只有 PC=0x0 时能取到第一条 addi; 执行到 PC=0x4 时取的是 ROM[0x1]=0x00000000, 后面的跳转目标也会全部错位, 仿真结果会和预期完全对不上.
调试时若盯着 ROM 面板, 会看到字地址 0x1 / 0x5; 文档对照应该采用字节 PC 0x4 / 0x14. 两者相差的就是那个 << 2, 不是程序本身装错了.
Info
注意这里采用的寄存器名称并不是ISA中的原始命名, 而是ABI助记符.
这里用到的寄存器有:
| Register(s) | ABI 助记符 | 用途 |
|---|---|---|
x0 | zero | 恒为 0;作 addi / jalr 的基址时,立即数就是绝对地址 |
x1 | ra | 返回地址;jalr 把 PC+4 写进 ra,便于子程序跳回 |
x10 | a0 | 参数 / 返回值寄存器;本程序里用来保存累加结果 |
逐行简要分析上面的程序:
| PC | 指令 | 效果 |
|---|---|---|
0x0 | addi a0, zero, 20 | x10 ← 20 |
0x4 | jalr ra, 16(zero) | x1 ← 8;跳到 0x10(<fun>) |
0x10 | addi a0, a0, 10 | x10 ← 30 |
0x14 | jalr zero, 0(ra) | 不写链接寄存器;PC ← x1 = 8 |
0x8 | jalr ra, 12(zero) | x1 ← 12;跳到 0xc(<halt>) |
0xc | jalr zero, 12(zero) | PC ← 12,原地循环,程序停在这里 |
最终 x10 = 30:
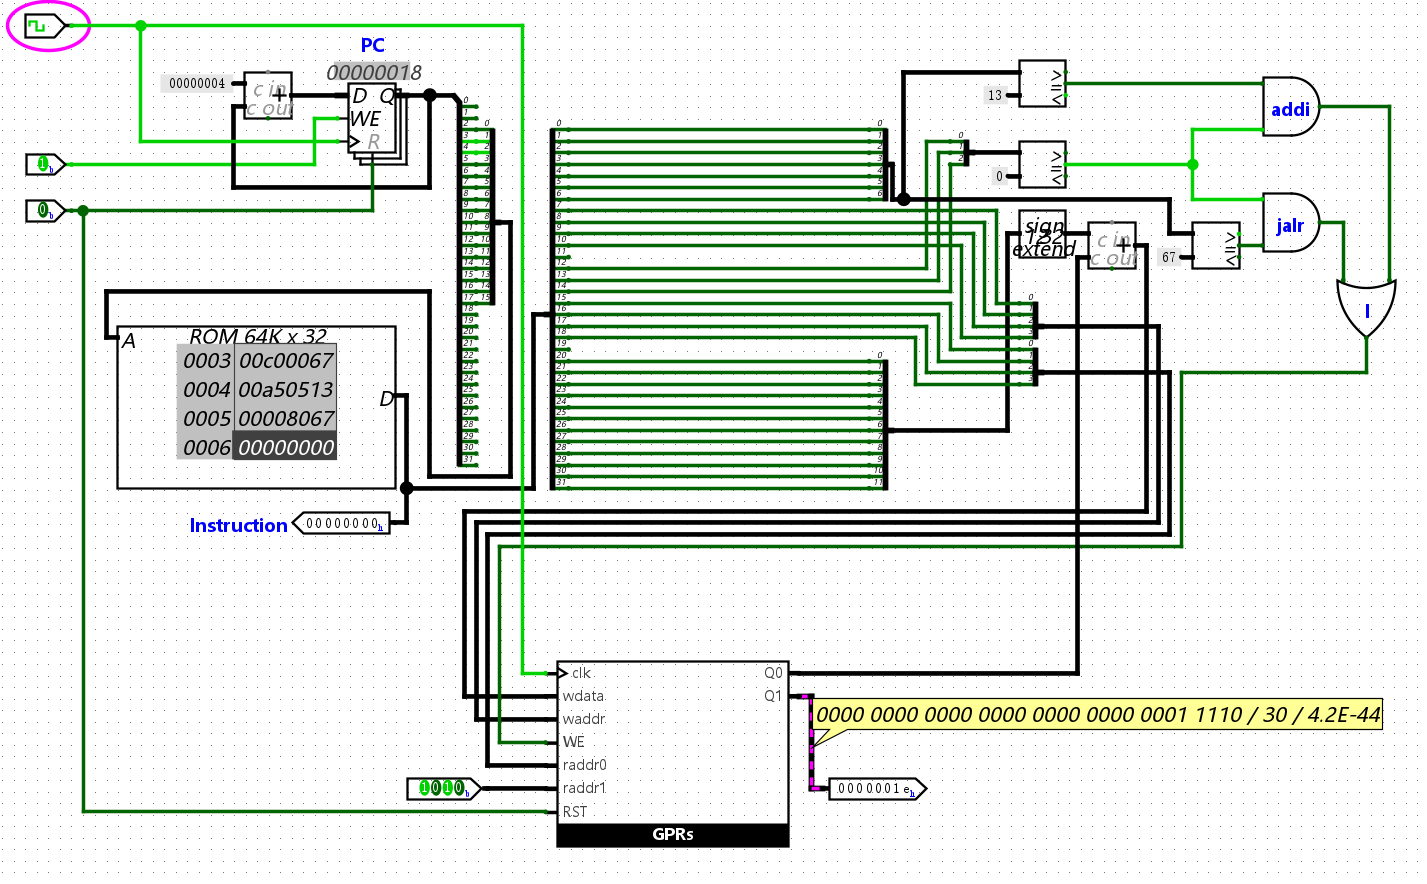
<halt> 用 jalr 跳回自身, 相当于停机环; <fun> 用 ra 保存返回地址, 再用 jalr zero, 0(ra) 返回.
Bug
上面的实现实际上有个致命但并不是很明显的问题 (其实还是挺明显的, 在仿真时停下来思考一下jalr指令的作用就会很快发现问题): 虽然寄存器的值最后是符合预期的, 但是在执行到最后的0xc时, 程序并没有如预期般陷入指令自旋, 这说明jalr指令的执行实际上是有问题的.
其实当时PC仍只会 +4, jalr 并没有改 PC, 也没有把 PC+4 链进 ra. 程序只是按 ROM 顺序一路落到 0x10 的 addi, a0 碰巧加到了 30; 到了文档里的 0xc 时也不会原地自旋. 对照上面的逐行轨迹 (调用 → <fun> → 返回 → <halt>), 说明控制流根本没按 jalr 语义走.
jalr 相对 addi, 操作数计算可以共用, 但结果必须分流.
因此正确的实现与执行效果应为:
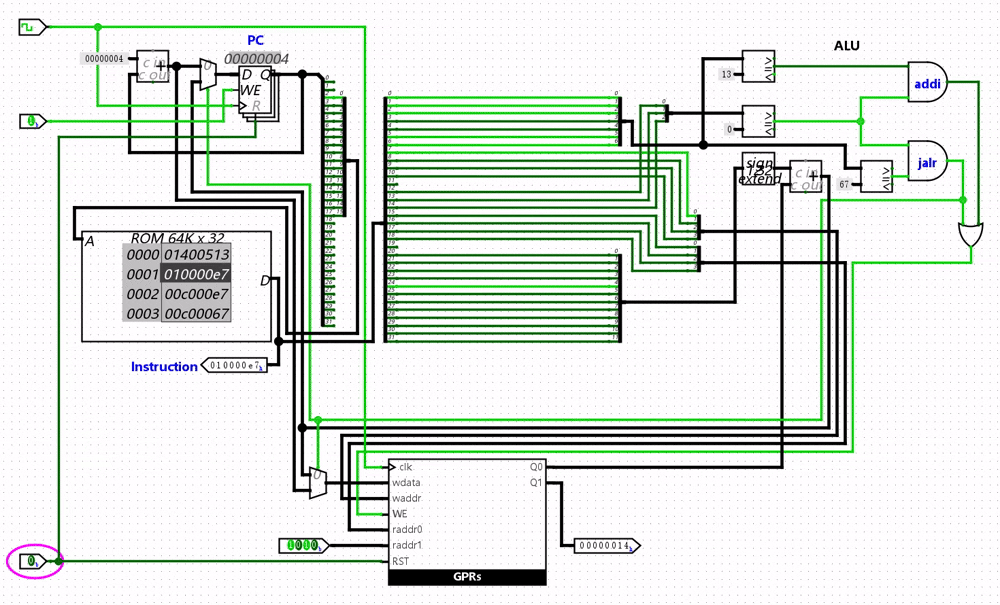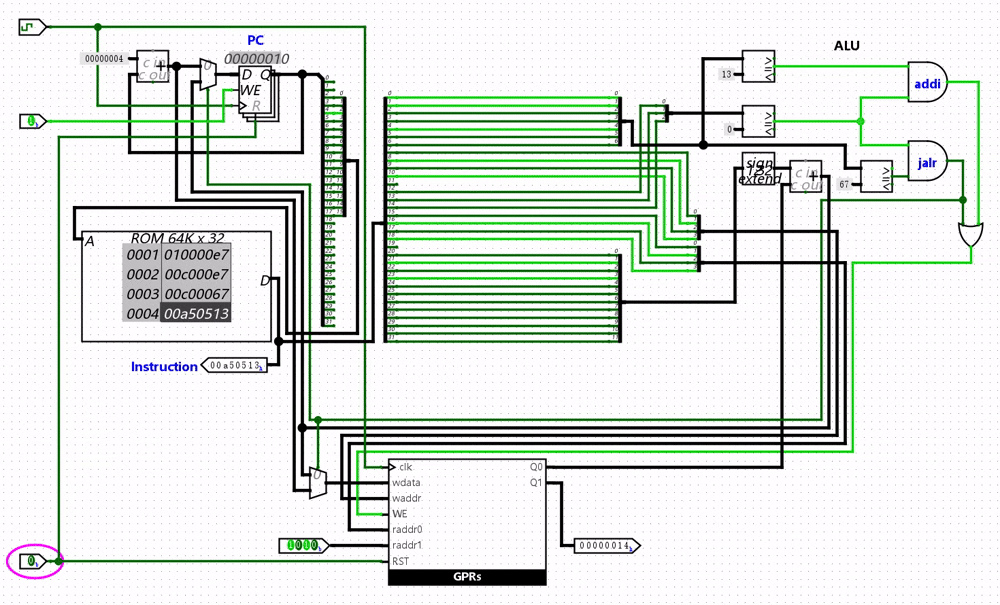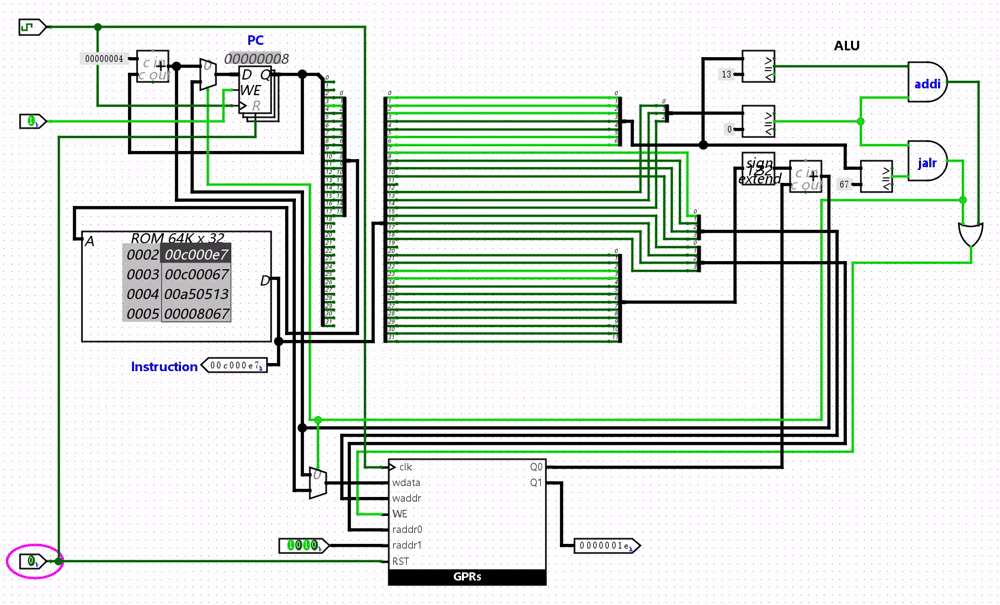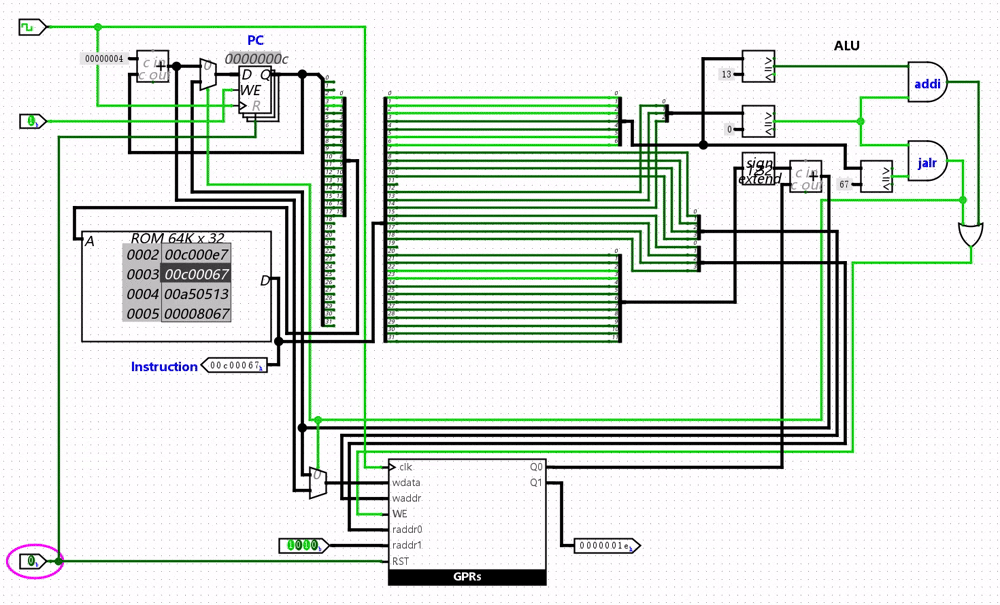
除此之外还要考虑零寄存器 x0与其他通用寄存器的区别, 读恒为 0, 写忽略:
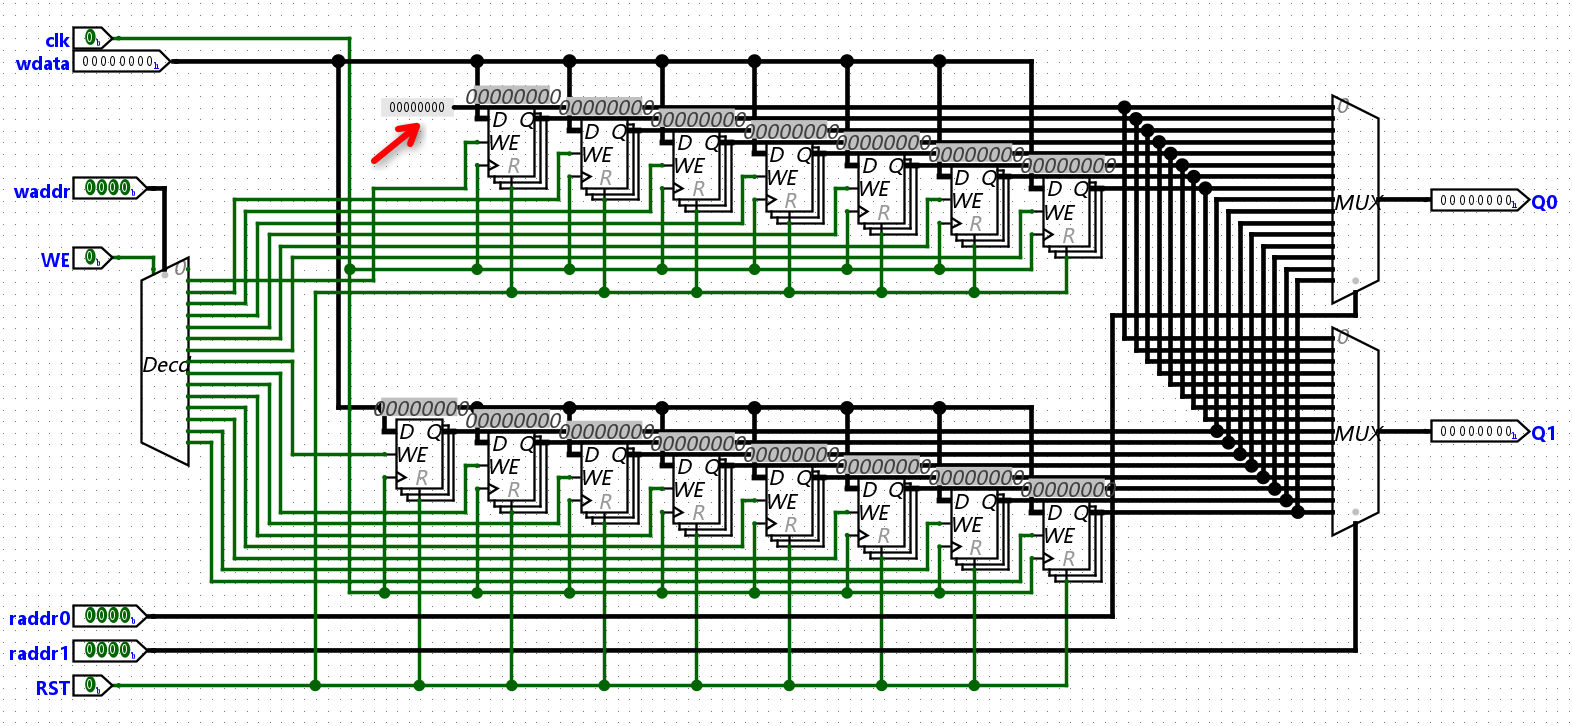
若不加以区分, 即使跳转已经接对, 仍可能出现a0的末态对了但在程序结束后还是进不了指令自旋的情况:
-
0x14的jalr zero, 0(ra)会把PC+4写进x0 -
随后
0x8的jalr ra, 12(zero)用的基址已不是 0, 目标变成x0+12, 也就跳转不到0xc -
即便到了
0xc,jalr zero, 12(zero)也会污染x0, 导致下一拍跳出自旋
I型指令汇总解码
随着指令数量的叠加, 电路也会越来越复杂. 倘若还是将所有的电路全部全部挤在main电路中, 布线难度会急剧攀升, 因此从实现第三条指令开始, 我们应该开始考虑将电路进行模块化处理.
模块化的思路也很简单, 显然相似的指令格式在电路的实现上能够互相复用, 这样能够极大地简化电路的复杂度, 这时划分指令布局类型的作用就体现出来了.
首先考虑I型指令, 其布局大致如下:
31         25 24    20 19   15 14    12 11        7 6        0
+------------+--------+-------+--------+-----------+----------+
|      imm[11:0]      |  rs1  | funct3 |    rd     |  opcode  |  I: ALU imm, loads, jalr
+------------+--------+-------+--------+-----------+----------+
除了上面已实现的addi和jalr指令外, 在minirv32中, I型指令还包括lbu和lw指令:
LBU指令
lbu指令用于从内存中加载一个字节, 并将其零扩展到32位. 加载的地址与下面的lw指令相同, 都是R[rs1] + imm.
观察lbu指令的格式:
31         25 24    20 19   15 14    12 11        7 6        0
+------------+--------+-------+--------+-----------+----------+
|      imm[11:0]      |  rs1  |  100   |    rd     | 0000011  |  lbu   zero-ext byte load
+------------+--------+-------+--------+-----------+----------+
-
opcode:
0x03(0000011) -
funct3:
100 -
rd:
inst[11:7] -
rs1:
inst[19:15] -
imm[11:0]:
inst[31:20]
LW指令
lw指令用于从内存中加载一个32位的字.
观察lw指令的格式:
31         25 24    20 19   15 14    12 11        7 6        0
+------------+--------+-------+--------+-----------+----------+
|      imm[11:0]      |  rs1  |  010   |    rd     | 0000011  |  lw    R[rd]=M[R[rs1]+imm]
+------------+--------+-------+--------+-----------+----------+
-
opcode:
0x03(0000011) -
funct3:
010 -
rd:
inst[11:7] -
rs1:
inst[19:15] -
imm[11:0]:
inst[31:20]
电路实现
综合四条指令的特点, 可以得出以下实现要点:
指令解析抽象
-
opcode有三种数值:0x13(0010011),0x03(0000011)和0x67(1100111), 分别对应addi,lbu/lw和jalr指令. -
funct3也有三种数值:0x0(000),0x4(100)和0x2(010), 分别对应addi/jalr,lbu和lw指令. -
立即数与通用寄存器地址布局一致.
寄存器交互
-
四条指令均包含
rd字段, 均需要写入通用寄存器. -
jalr指令还需要写入PC寄存器, 从PC寄存器读取地址并写回通用寄存器. -
I 型四条指令的写回是两级选择:
\[ \textit{load_data} = \begin{cases} \{24'b0,\; M[31:0]\langle addr[1:0]\rangle\} & lbu \\ M[31:0] & lw \end{cases} \]\[ \textit{GPRwdata} = \begin{cases} \textit{load_data} & lbu \lor lw \\ PC+4 & jalr \\ R[rs1]+\textit{imm} & addi \end{cases} \]\[ PC\cdot D = \begin{cases} (R[rs1]+\textit{imm})\ \&\ \sim 1 & jalr \\ PC+4 & \text{otherwise} \end{cases} \]
加载-存储操作
-
lbu和lw指令均需要从内存中读取数据, 并将其写入通用寄存器. -
加载时的内存地址均为基址加上立即数 (
R[rs1] + imm), 这个结果不经过寄存器, 而是直接作为内存地址用. -
地址抽象必须与 ROM 对齐: RAM 字地址取
(R[rs1]+imm)[17:2], 也就是>> 2. 低 2 位addr[1:0]留下给下面提到的lbu字节访存做字节选择. -
字节访存
-
RAM读口一次给出的是整个字.
-
lbu要在 CPU 里做完"选字节 + 零扩展", 再送进已有的 load 写回 mux:-
字地址仍用
addr[17:2]去 RAM; 留下addr[1:0], 不要在进译码器之前就丢掉. -
用分线器把
RAMdata[31:0]拆成 4 个 8 位:[7:0],[15:8],[23:16],[31:24]. -
4 选 1 mux, 选择端接
addr[1:0], 选出那一个字节 (小端, 与RAM 字节槽一致). -
使用零扩展, 得到
lbu的GPRwdata.
-
-
lw直接用整字. -
字节访存发生在 RAM 之后, 写回 mux 之前;
lbu用 4:1 mux + 零扩展得到 32 位,lw旁路. 读使能 \(RAMren = lbu \lor lw\) 即可.
-
输出
-
指向GPRs写使能的
GPRwe -
经过解析与处理后将写入GPRs的数据
GPRwdata -
经过解析与处理后得出的RAM地址信息
RAMaddr -
执行
lbu和lw指令时需要的RAM读使能信号RAMren -
jalr指令中经过处理后的PC信息PCdata
电路实现如下:
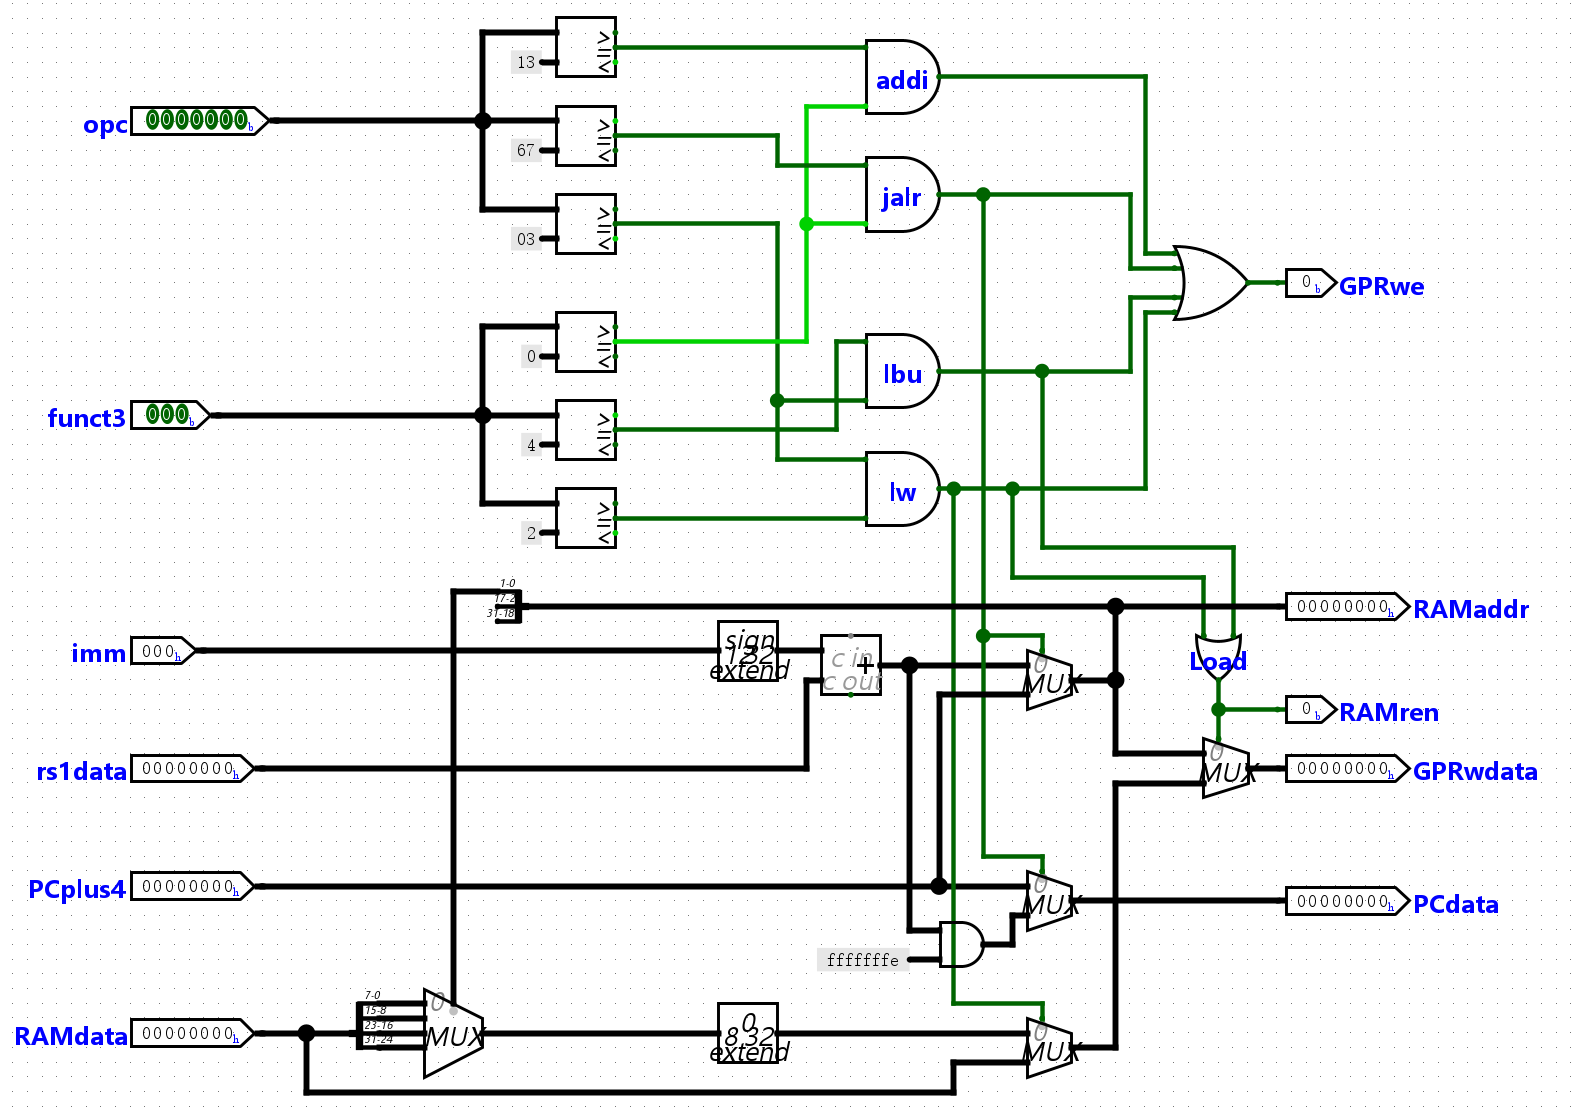
至于为什么没有GPR地址相关的字段解析, 见通用寄存器交互控制对此的解释, 下面的其他指令译码模块同理.
R型指令解码
minirv32中目前只有add指令为R型指令, 其格式如下:
31         25 24    20 19   15 14    12 11        7 6        0
+------------+--------+-------+--------+-----------+----------+
|  0000000   |  rs2   |  rs1  |  000   |    rd     | 0110011  |  add   R[rd]=R[rs1]+R[rs2]
+------------+--------+-------+--------+-----------+----------+
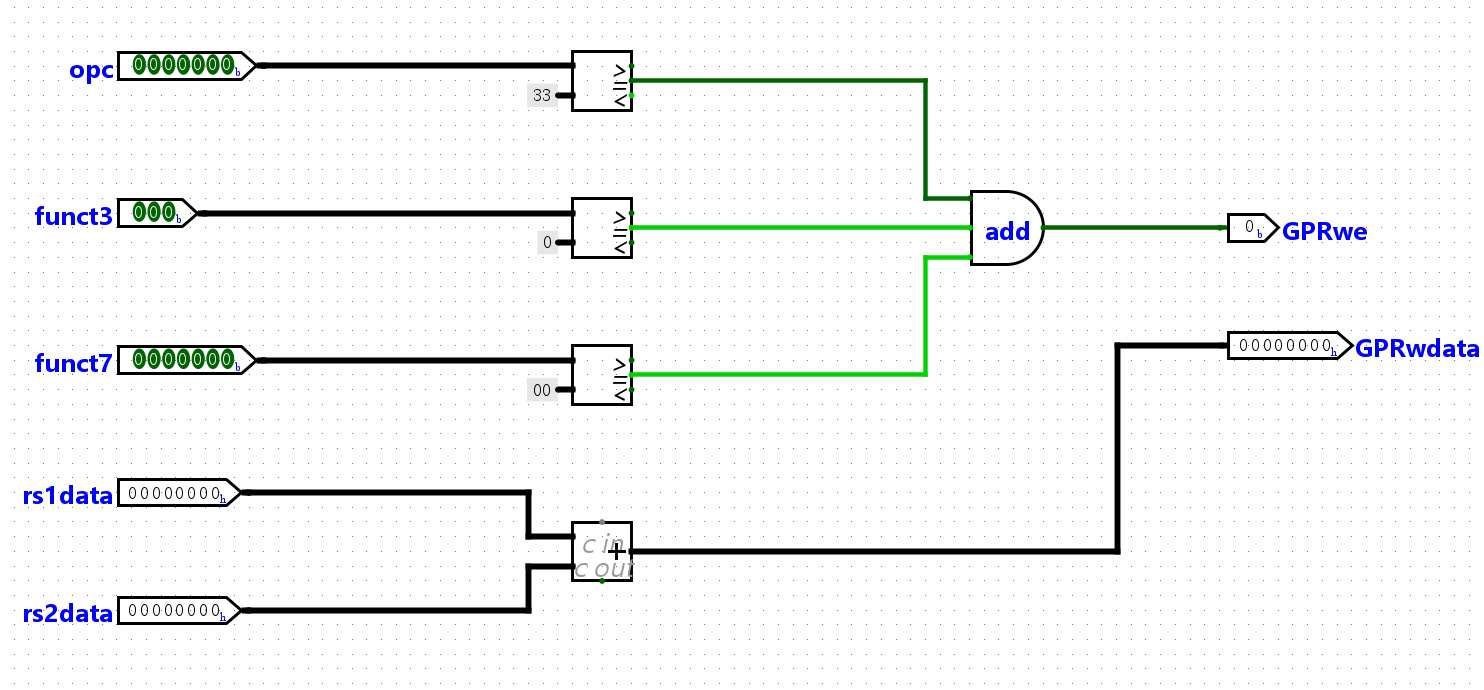
逻辑实际上和sCPU中的add指令没什么区别.
只需考虑该指令的解析抽象:
-
opcode为0x33(0110011). -
funct3为0x0(000). -
funct7为0x0(0000000).
电路实现如下:
U型指令解码
与R型指令一样, minirv32中也只有一个U型指令. 即lui指令:
31         25 24    20 19   15 14    12 11        7 6        0
+------------+--------+-------+--------+-----------+----------+
|              imm[31:12]              |    rd     | 0110111  |  lui   R[rd]=imm<<12
+------------+--------+-------+--------+-----------+----------+
实现这个指令就更简单了.
首先逻辑同样与sCPU中的li指令差不多, 都是把立即数装进寄存器; 其次在指令解析层面它只有opcode字段需要比较.
不过需要留意的是:
-
ISA 语义层面, 左移操作的目的是把这 20 位立即数放到寄存器的高 20 位, 低 12 位清 0, 以便再和
addi的 12 位立即数拼出完整 32 位常数. -
电路实现层面, U 型编码已经把这 20 位放在
inst[31:12], 因此不必真的接一个移位器, 直接取指令的高 20 位, 再在低 12 位补 0 即可, 结果等价于imm << 12: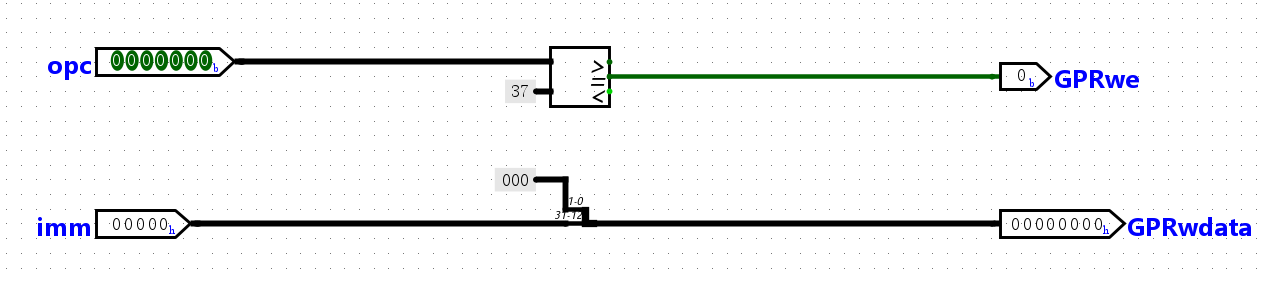
Review
回顾sCPU的li指令, 立即数在指令低位, 写入前是高位补 0 (零扩展). lui 则是立即数在指令高位字段, 写入时低位补 0. 两者都是装立即数, 差别在字段位置和补零方向, 而不是「因为在高位才需要左移」.
S型指令解码
minirv32中包含两个S型指令. S型指令的通用格式如下:
31         25 24    20 19   15 14    12 11        7 6        0
+------------+--------+-------+--------+-----------+----------+
| imm[11:5]  |  rs2   |  rs1  | funct3 | imm[4:0]  |  opcode  |  S: stores
+------------+--------+-------+--------+-----------+----------+
S型指令最显著的特征就是需要写入RAM, 且均不写回通用寄存器.
SB指令
sb指令用于向内存写入一个字节, 只更新目标字中对应的那一个字节, 其余字节保持不变. 写入地址与sw / lw / lbu相同, 都是R[rs1] + imm (立即数需符号扩展); 要写入的数据来自R[rs2]的最低 8 位.
观察sb指令的格式:
31         25 24    20 19   15 14    12 11        7 6        0
+------------+--------+-------+--------+-----------+----------+
|  imm[11:5] |  rs2   |  rs1  |  000   |  imm[4:0] | 0100011  |  sb    store low byte
+------------+--------+-------+--------+-----------+----------+
-
opcode:
0x23(0100011) -
funct3:
000 -
rs1:
inst[19:15](基址寄存器) -
rs2:
inst[24:20](要写入内存的数据来源) -
imm[11:5]:
inst[31:25] -
imm[4:0]:
inst[11:7]
与 I 型不同, S 型的 12 位立即数被拆成两段夹在rs2两侧, 拼起来仍是imm[11:0], 再符号扩展到 32 位后与R[rs1]相加得到地址. 因为不写回GPRs, 所以没有目的寄存器编号.
SW指令
sw指令用于向内存写入一个 32 位字, 把R[rs2]的全部 32 位写到地址R[rs1] + imm处.
观察sw指令的格式:
31         25 24    20 19   15 14    12 11        7 6        0
+------------+--------+-------+--------+-----------+----------+
|  imm[11:5] |  rs2   |  rs1  |  010   |  imm[4:0] | 0100011  |  sw    M[R[rs1]+imm]=R[rs2]
+------------+--------+-------+--------+-----------+----------+
-
opcode:
0x23(0100011) -
funct3:
010 -
rs1:
inst[19:15] -
rs2:
inst[24:20] -
imm[11:5]:
inst[31:25] -
imm[4:0]:
inst[11:7]
可见sb与sw的字段布局完全一致, 只靠funct3区分宽度 (000写字节, 010写字), 正如lbu与lw共用 load 的 opcode、靠funct3区分一样.
电路实现
指令解析抽象
-
二者的
opcode字段完全一致, 均为0x23(0100011). -
译码需依靠
funct3字段区分指令类型,0x0(000)对应sb,0x2(010)对应sw. -
立即数
imm在指令中不是连续的, 而是被拆成了两段夹在rs2两侧, 因此需要拼接成完整的立即数, 然后进行扩展.
寄存器交互
-
只有读取操作, 无需写回.
-
需同时读取两个通用寄存器.
加载-存储操作
-
两个指令均需要写入RAM, 但不写回通用寄存器.
-
涉及RAM的字地址解析同I型指令的两个加载指令:
(R[rs1]+imm)[17:2]. -
用 4 位字节使能区分宽度, 这里就不能仅使用
RAMwen对整字一刀切了, 而是需要根据指令类型选择不同的字节使能:sw使能1111;sb按addr[1:0]独热; 非 S 型时四根都为 0. 写数据在sb时复制低字节到四个槽,sw时原样接R[rs2]:-
字地址同样取
addr[17:2];addr[1:0]输入2-4译码器, 得到独热的4位字节使能 (0001/0010/0100/1000). -
写数据不应只把
R[rs2][7:0]放在最低字节, 而是应该把R[rs2][7:0]复制四份拼成 32 位{b,b,b,b}, RAM 的第k根字节使能写的是数据口的第k个字节槽, 字节使能会丢掉另外三槽. -
sw时四根使能全 1, 数据口直接接R[rs2]. 组合逻辑为: \(BE = sw ? 4'b1111 : (is_sb ? (4'b0001 << addr[1:0]) : 4'b0000)\).
-
电路实现如下:
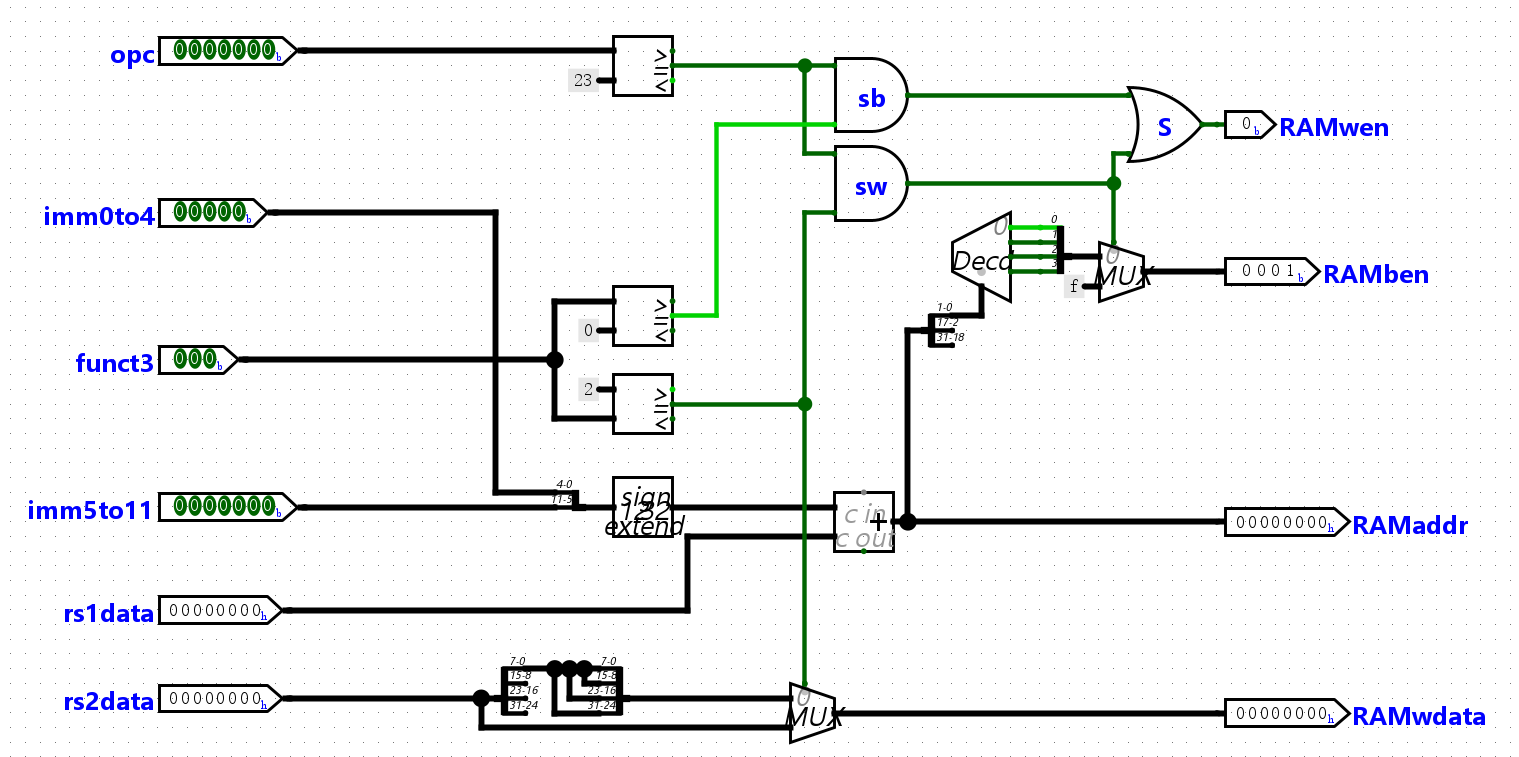
通用寄存器交互控制
针对指令的解码模块按照指令格式划分成了四种, 上面以这四种指令格式为依据实现了四种指令的解码电路, 这些电路中均存在GPR交互的需求, 因此可以考虑将这些GPR交互的需求抽象出来, 单独实现一个GPR交互控制模块.
交互模块不必把四路译码的全部端口都仲裁一遍. 地址从指令字段直出, 读数据从 GPRs 扇出; 本模块只处理 GPRwe 和 GPRwdata.
交互信号分类
GPR 视角下的端口无非五大类:
| 方向 | 信号 | 位宽 | 含义 |
|---|---|---|---|
| 译码 → GPR | GPRwe | 1 | 写使能 |
| 译码 → GPR | GPRwaddr | 4 | 写地址 (16 个寄存器, 对应 rd[3:0]) |
| 译码 → GPR | GPRraddr0, GPRraddr1 | 4 | 两个读口地址rs1/rs2 |
| 译码 → GPR | GPRwdata | 32 | 写数据 |
| GPR → 译码 | GPRrdata0, GPRrdata1 | 32 | 两个读口数据Q0/Q1 |
读数据是 GPRs 的输出, 直接扇出回 I / R / S 的 rs1data / rs2data, 不必进交互模块.
但在指令译码器的视角下, 不同类型(格式)的指令对 GPR 的交互需求并不相同:
| 格式 | 指令 | we | waddr | raddr0 | raddr1 | wdata 来源 |
|---|---|---|---|---|---|---|
| I | addi / jalr / lbu / lw | 匹配则为 1 | rd | rs1 | — | ALU / PC+4 / M[] |
| R | add | 匹配则为 1 | rd | rs1 | rs2 | R[rs1]+R[rs2] |
| U | lui | 匹配则为 1 | rd | — | — | imm<<12 |
| S | sb / sw | 恒为0 (不写回 GPR) | — | rs1 | rs2 | — |
同一时刻最多一种格式命中 (opcode / funct3 互斥), {Iwe, Rwe, Uwe} 独热.
地址方面则无需仲裁, rd/rs1/rs2在指令里的位段与格式无关, 四路译码输出的地址始终是同一组数据. 因此在前面实现的指令译码模块中均未包含寄存器地址相关的字段解析.
交互模块只需要负责判定要不要写, 写什么数据. S型指令不写入 GPR, 也就不需要经过交互控制模块.
控制方案
对写数据用独热组合逻辑进行选择控制:
这里的 \(\land\) 是 32 位按位与, 1 位使能必须先使用符号扩展成32位以匹配wdata的位宽, 注意不能零扩展.
为什么不能使用零扩展
零扩展会把 1 变成 0x00000001, 按位与后只留下 wdata[0], 高 31 位全被清掉.
在一生一芯提供的验证程序中, _start 里 addi ra, zero, 556 (0x22c 的 LSB 是 0) 会把 ra 写成 0, 随后 jalr ra, 0(ra) 跳回地址 0, 表现为在 _start 里死循环.
交互控制模块的电路实现如下:
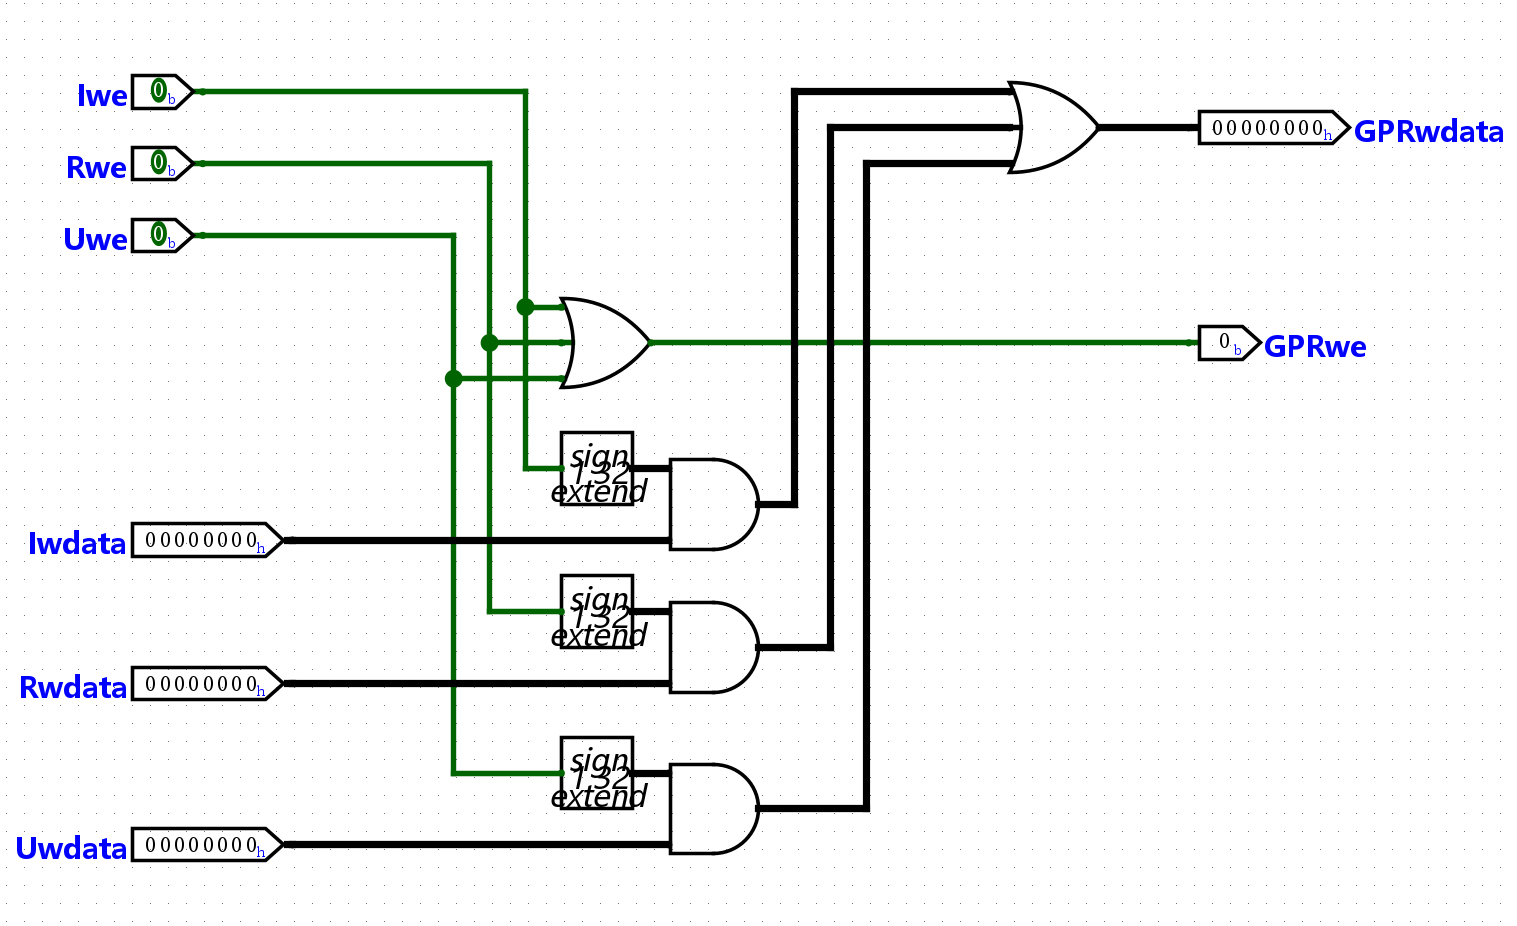
写发生在时钟沿, 读是组合的, 本拍写入的值下一拍才能读到, 单周期 CPU 正需要这样.
处理器功能验证
基础测试
LUI指令
00001537  lui   a0, 0x1
01150513  addi  a0, a0, 0x11
00800067  jalr  zero, 8(zero)
lui a0, 1 应得到 0x1000, 再 addi 一次确认低 12 位. 末态为: PC = 0x8, a0 = 0x1011.
ADD指令
00300513  addi  a0, zero, 3
00500593  addi  a1, zero, 5
00b50533  add   a0, a0, a1
00c00067  jalr  zero, 12(zero)
3 + 5 = 8. 末态为: PC = 0xc, a0 = 8.
JALR指令
00100513  addi  a0, zero, 1
00c00067  jalr  zero, 12(zero)
06450513  addi  a0, a0, 100
00150513  addi  a0, a0, 1
01000067  jalr  zero, 16(zero)
这里主要测试 jalr 的控制流功能, 中间的addi a0, a0, 100在预期中是不能执行的, 末态为: PC = 0x10, a0 = 2. 若 a0 变成 102 或 PC 走到 0x10 之后, 就说明其控制流存在问题.
加载-存储指令
02000513  addi  a0, zero, 0x20
05a00593  addi  a1, zero, 0x5a
00b52023  sw    a1, 0(a0)
00052603  lw    a2, 0(a0)
00b00593  addi  a1, zero, 0xb
00b500a3  sb    a1, 1(a0)
00154683  lbu   a3, 1(a0)
01c00067  jalr  zero, 28(zero)
sw 整字, sb 只改一个字节槽.
地址用 0x20 (在栈下方, 避开代码). 末态为: PC = 0x1c, a2 = 0x5a, a3 = 0xb; 若小端和字节使能都对, 再 lw 一次应看到 0x00000b5a.
sb 之后若 a2 仍是 0x5a 而 lw a2, 0(a0) 变成 0x00000b5a, 说明写字节没有误伤同字其它槽. 把最后的 jalr 换成再取一次 lw 即可看整字.
边界测试
上面的程序都只是对各个指令的基础功能进行了测试(如指令的译码, 寄存器的基本交互等), 主要是为了验证处理器能不能正常识别各个指令并按照约定进行数据通路的控制. 但显然上面的测试没有覆盖某些边界情况:
12 位负数立即数, S 型负偏移(栈), jalr ra, 0(ra)同拍读写, jalr zero, 0(rs1)间接跳转, 以及查表数据必须从RAM读取.
因此需要编写一些相对复杂的, 具有针对性的测试程序来进一步验证处理器的功能. 下面的测试程序均是针对一生一芯提供的验证程序sum和mem涉及到的一些边界情况进行编写的.
负数ADDI
sum 里 addi sp, sp, -16、check 里 sum - 5050 都靠 12 位符号扩展.
00500513  addi  a0, zero, 5
fff50513  addi  a0, a0, -1
ffc50513  addi  a0, a0, -4
00c00067  jalr  zero, 12(zero)
末态 PC = 0xc, a0 = 0.
负偏移栈
check 第一条就是 sw a0, -16(sp). S 型立即数拆在 imm[11:5] 和 imm[4:0], 拼错会写到别的字.
04000513  addi  a0, zero, 0x40
01100593  addi  a1, zero, 0x11
feb52823  sw    a1, -16(a0)
ff052603  lw    a2, -16(a0)
01000067  jalr  zero, 16(zero)
基址 0x40, 目标字节地址 0x30 (RAM 字地址 0xc). 末态 PC = 0x10, a2 = 0x11.
同拍读写
rd 和 rs1 都是 ra 的情况下, 必须用时钟沿之前的 ra 当跳转目标, 本拍再把 PC+4 写进 ra.
00100513  addi  a0, zero, 1
01000093  addi  ra, zero, 16
000080e7  jalr  ra, 0(ra)
06450513  addi  a0, a0, 100
00150513  addi  a0, a0, 1
01400067  jalr  zero, 20(zero)
写穿的话会跳到下一条, a0 变成 102. 正确的跳转应为: 先跳到 0x10, 在继续往下执行; 末态 PC = 0x14, a0 = 2, ra = 0xc.
调用后返回
halt 和函数返回都是 rd = x0 的 jalr, PC 仍必须改, 只是不写寄存器.
01400513  addi  a0, zero, 20
010000e7  jalr  ra, 16(zero)
00c00067  jalr  zero, 12(zero)
00c00067  jalr  zero, 12(zero)
00a50513  addi  a0, a0, 10
00008067  jalr  zero, 0(ra)
末态 PC = 0xc, a0 = 0x1c(30).
若 a0 = 20, 则说明没跳进函数; 若最后没有陷入指令自旋, 则说明返回或 halt 的 jalr 没正确修改 PC.
LUI组合负数ADDI
sum 末尾是 lui a5, 0xfffff (0xfffff000, 即 -4096) 再 addi a5, a5, -954 得到 -5050. 下面用 -10 缩小: -4096 + (-10) = -4106. 左边用 lui a0, 1 再 addi 10 得到 +4106 与之抵消.
00001537  lui   a0, 0x1
00a50513  addi  a0, a0, 10
fffff5b7  lui   a1, 0xfffff
ff658593  addi  a1, a1, -10
00b50533  add   a0, a0, a1
01400067  jalr  zero, 20(zero)
末态 PC = 0x14, a0 = 0, a1 = 0xffffeff6 (-4106).
若 a1 停在 0xfffff000, 则负 addi 没加上; 若 a1 = 0xfffff000 + 0xff6 = 0xfffffef6 (正的 0xff6), 则立即数被零扩展; 若 a0 低 12 位仍是脏的, 则说明 lui 没有把 [11:0] 清零.
无分支迷你求和
1+2+3+4+5 = 15, 不用 bne.
00000513  addi  a0, zero, 0
00150513  addi  a0, a0, 1
00250513  addi  a0, a0, 2
00350513  addi  a0, a0, 3
00450513  addi  a0, a0, 4
00550513  addi  a0, a0, 5
01800067  jalr  zero, 24(zero)
末态 PC = 0x18, a0 = 0xf.
若该程序能够通过测试而完整 sum 不能, 则说明问题在控制流 / 查表 / 栈, 不在 add.
四字节槽读写
基础测例只改过偏移 1. mem 会打 0/1/2/3. 小端整字应为 0xa3a2a1a0.
02000513  addi  a0, zero, 0x20
0a000593  addi  a1, zero, 0xa0
00b50023  sb    a1, 0(a0)
0a100593  addi  a1, zero, 0xa1
00b500a3  sb    a1, 1(a0)
0a200593  addi  a1, zero, 0xa2
00b50123  sb    a1, 2(a0)
0a300593  addi  a1, zero, 0xa3
00b501a3  sb    a1, 3(a0)
00054603  lbu   a2, 0(a0)
00154683  lbu   a3, 1(a0)
00254703  lbu   a4, 2(a0)
00354783  lbu   a5, 3(a0)
00052583  lw    a1, 0(a0)
03800067  jalr  zero, 56(zero)
末态 PC = 0x38, a2 = 0xa0, a3 = 0xa1, a4 = 0xa2, a5 = 0xa3, a1 = 0xa3a2a1a0.
哪个偏移的 lbu 不对, 就去对 I 型 4:1 mux 的那一路, 以及 RAM 字节使能引脚是不是高字节在上或者和 addr[1:0] 反了.
栈上间接跳转
sum 不真正有 bne: 把两个目标 sw 到栈上, 按条件算出地址, lw 出来再 jalr zero, 0(tp). 下面强制条件为 0, 应走 not-taken = 0x44. 末态 PC = 0x48, a0 = 1.
| 末态 | 含义 |
|---|---|
a0 = 1, PC = 0x48 | 间接跳正确 |
a0 = 2, PC = 0x40 | lw 基址 / -16 与 -20 用反 |
a0 = 99, PC = 0x30 | jalr 没改 PC, 或 lw 到了 0 |
08000113  addi  sp, zero, 0x80
03c00193  addi  gp, zero, 0x3c
fe312823  sw    gp, -16(sp)
04400193  addi  gp, zero, 0x44
fe312623  sw    gp, -20(sp)
00000213  addi  tp, zero, 0
00420233  add   tp, tp, tp
00420233  add   tp, tp, tp
00410233  add   tp, sp, tp
fec22203  lw    tp, -20(tp)
00020067  jalr  zero, 0(tp)
06300513  addi  a0, zero, 99
03000067  jalr  zero, 48(zero)
00000013  addi  zero, zero, 0
00000013  addi  zero, zero, 0
00200513  addi  a0, zero, 2
04000067  jalr  zero, 64(zero)
00100513  addi  a0, zero, 1
04800067  jalr  zero, 72(zero)
这段过了再跑 sum. sum 还要在 0x400 一带 lbu 查表; 那些字只存在 .hex 后半段, RAM 也要加载同一份镜像, 否则软件 bne 的条件永远是 0, 循环只跑一圈, 最后 check(sum == 5050) 失败, 看起来会像「算错了」或「冲进无意义区间」.
I/O设备
通过上面的所有测试后, 目前我们就已经实现了一个完整的minirv32处理器了.
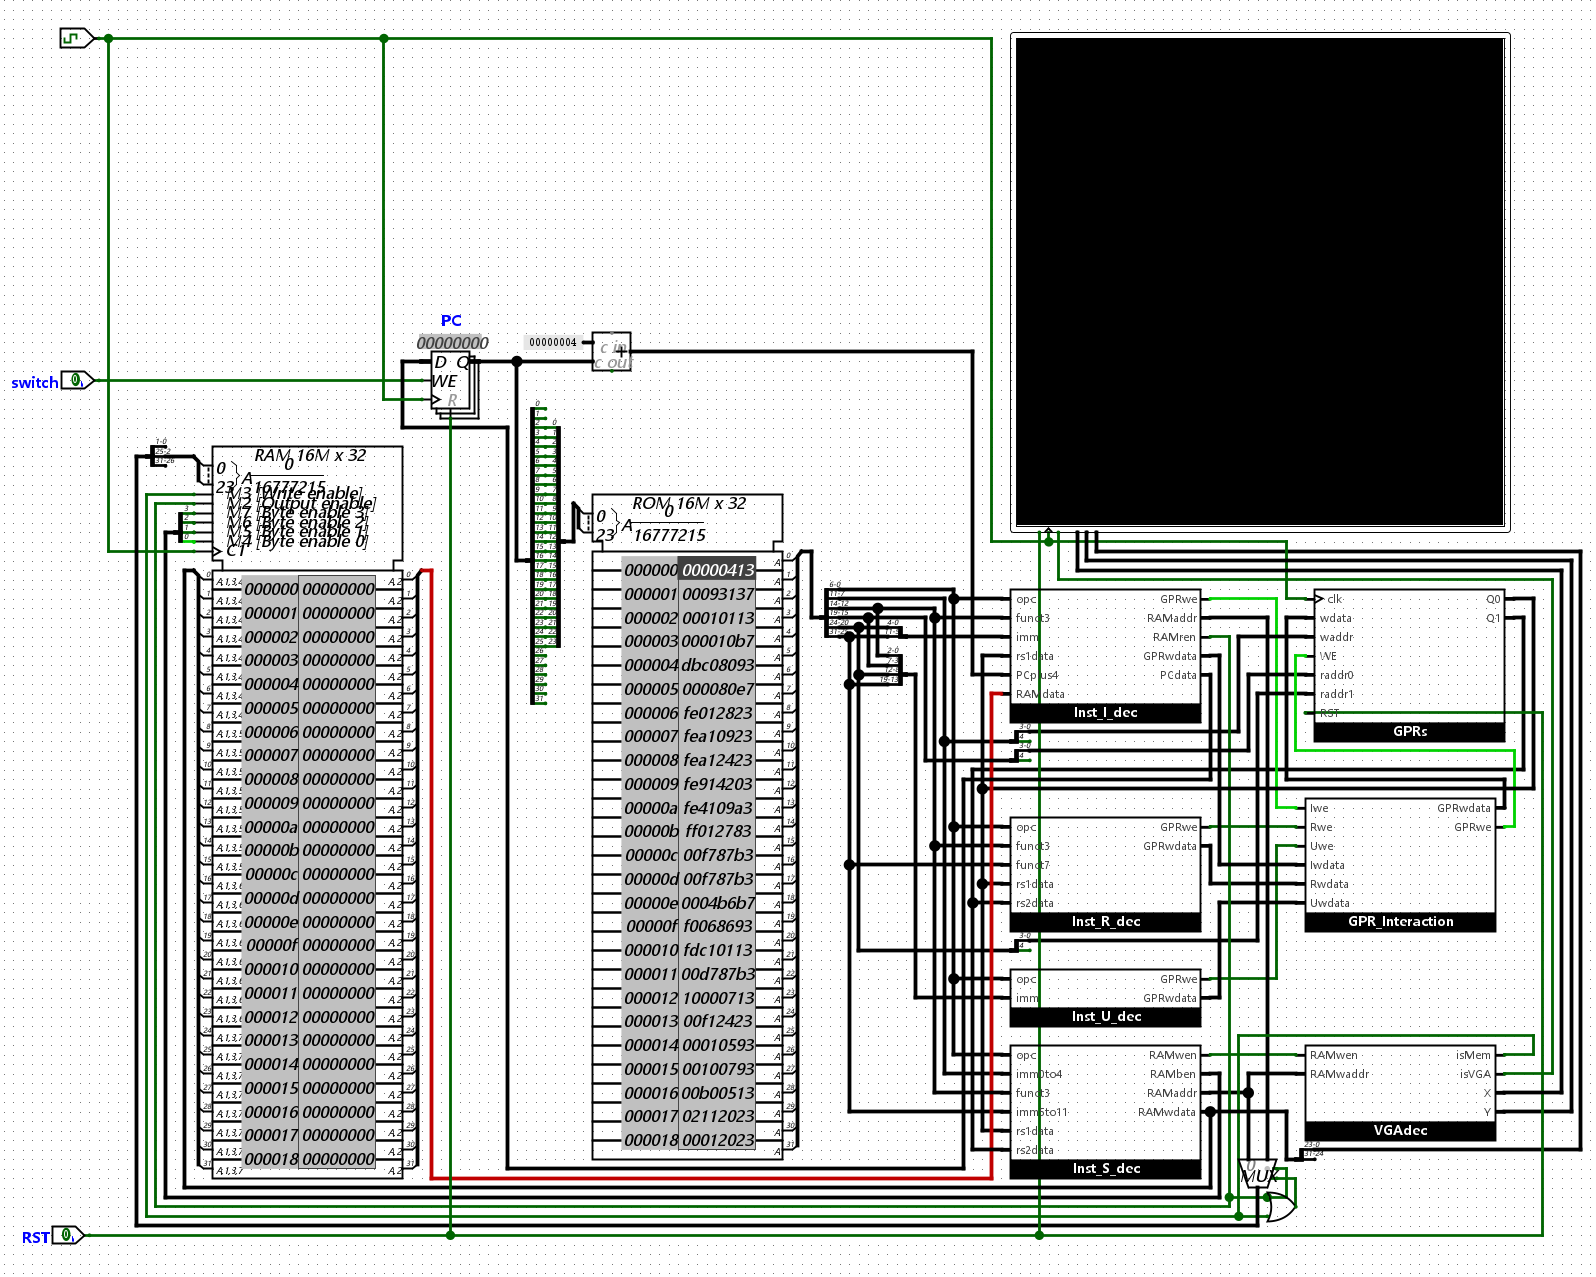
原则上来说, RV32I指令集能完成的功能, 这个处理器也可以完成.
为了能够将它的功能具象化, 接下来我们可以考虑为其添加一个显示屏让其渲染一些图片, 这就要用到一个Input/Output(输入/输出)元件: RGB Video.
类似RGB Video这样的部件称为外部设备, 简称"外设".
事实上, 如何访问外设属于ISA规范的其中一部分. 具体到RISC-V中, 访问外设是通过内存映射I/O(Memory-mapped I/O)方式来进行的. 这种方式的本质是, 根据访存地址的范围来决定处理器的访问对象是内存还是外设.
VGA编码
为了实现所谓"基于访存地址范围决定访问对象"的特性, 需要在存储器的地址通路上添加一个控制模块来控制数据1是写入内存还是写入外设; 同时, 为了简化处理, 我们考虑只允许sw指令写入VGA显示模块.
VGA屏幕的配置如下:
-
Cursor(光标) - No Cursor
-
Reset Behavior(重置行为) - Asynchronous
-
Color Model(颜色模式) - 888 RGB (24 bit)
-
Width(宽度) - 256
-
Height(高度) - 256
对图片编码稍有了解的话, 应该知道在888 RGB编码中, 一个像素占3个字节(即上面配置中提到的24 bit). 为了方便处理, 我们将其视为4字节以对齐内存字位宽. 这样, 整个屏幕所能呈现的数据大小就为 \(256 \times 256 \times 4 = 256KB\).
电路实现上, 了解了上面内存映射的本质和像素坐标在指令中的表示方式(即寻址原理), 实现起来就没有难度了:
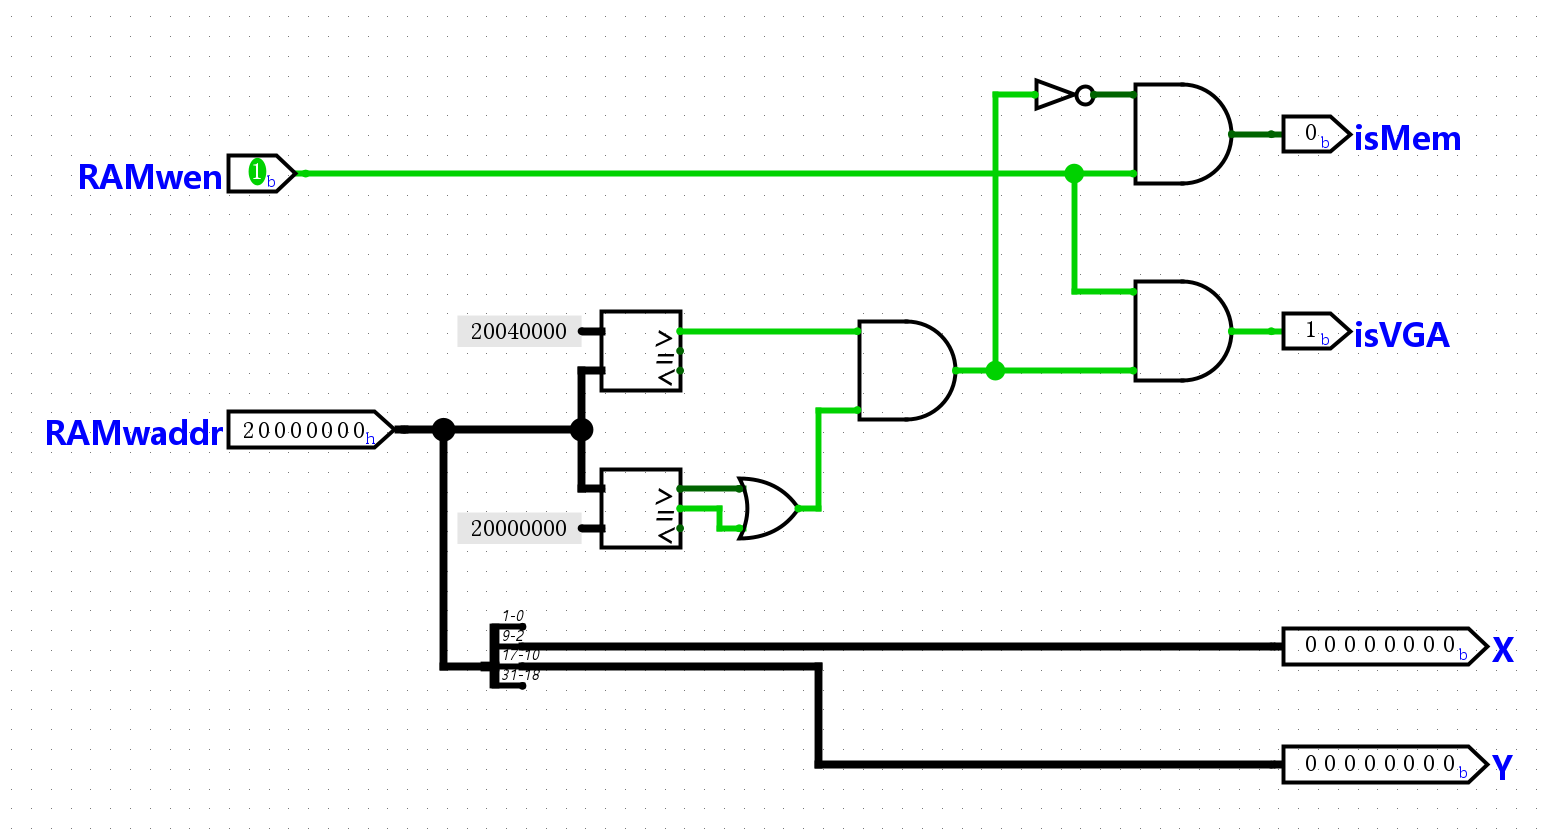
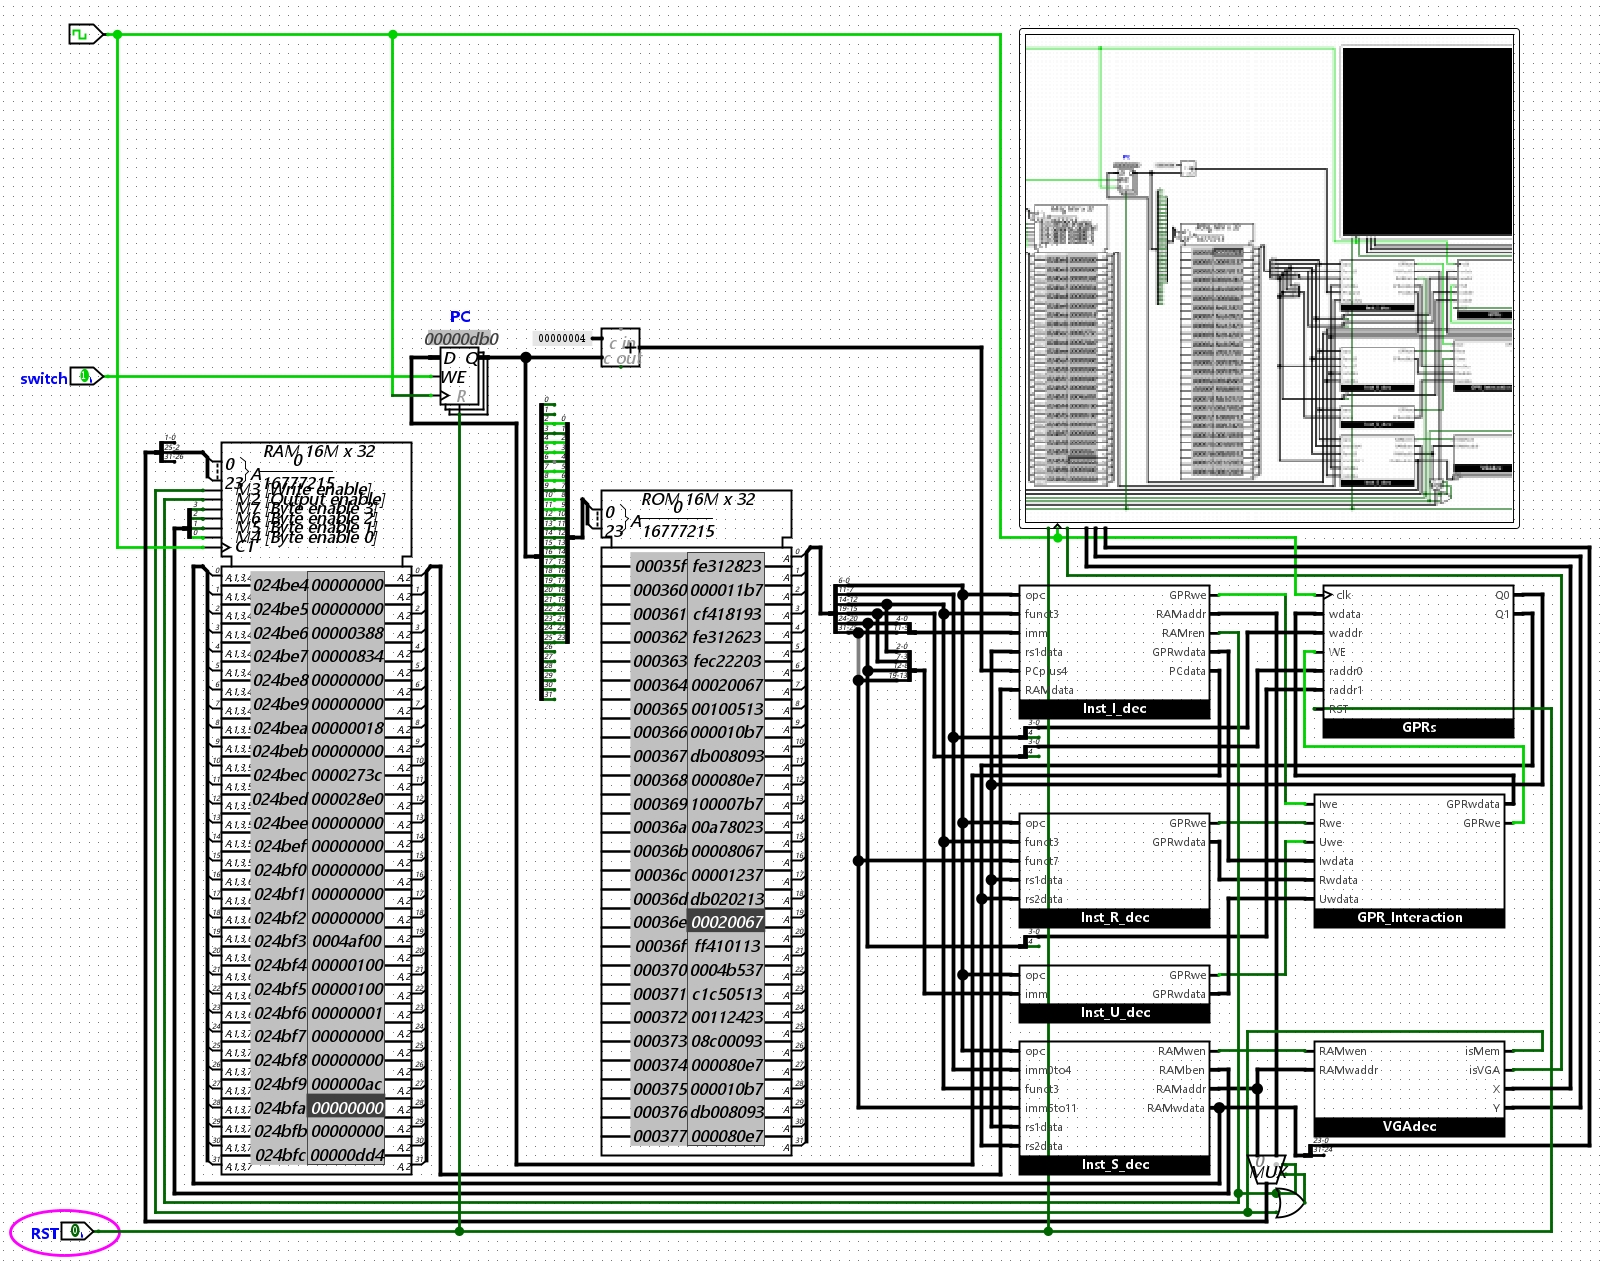
实现完成后, 就可以将其组装到前面实现的处理器中, 并进行验证了.
一生一芯官方提供了一个验证程序vga, 最终会在VGA屏幕上显示一生一芯的logo图标, 并陷入自旋:
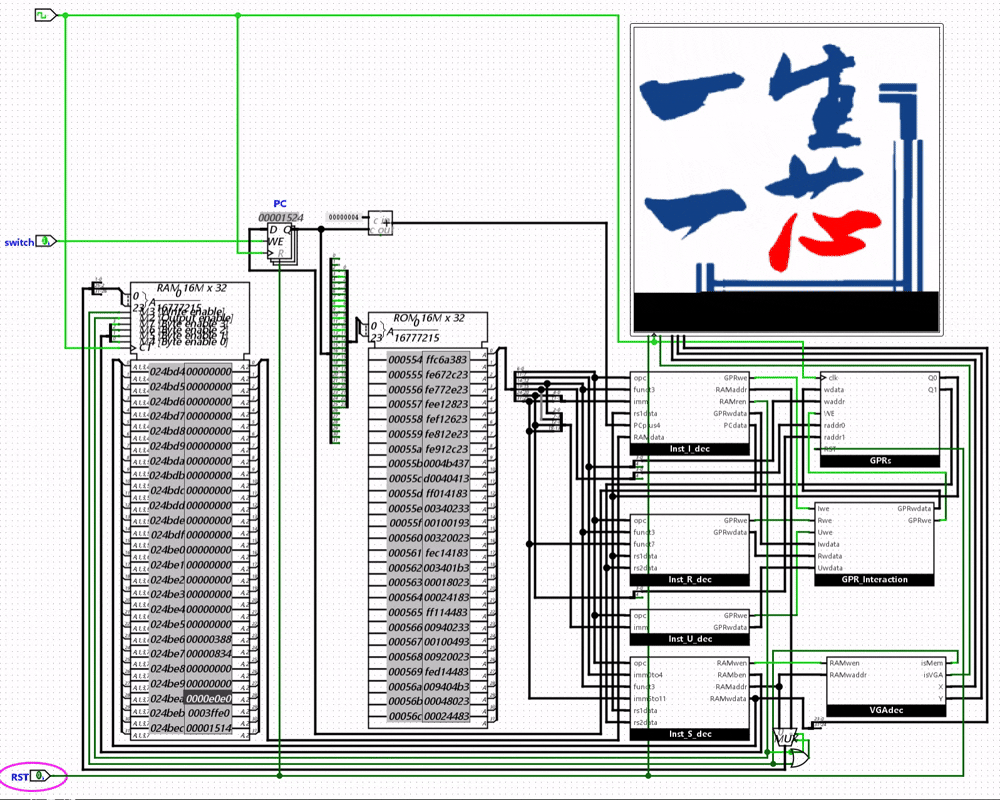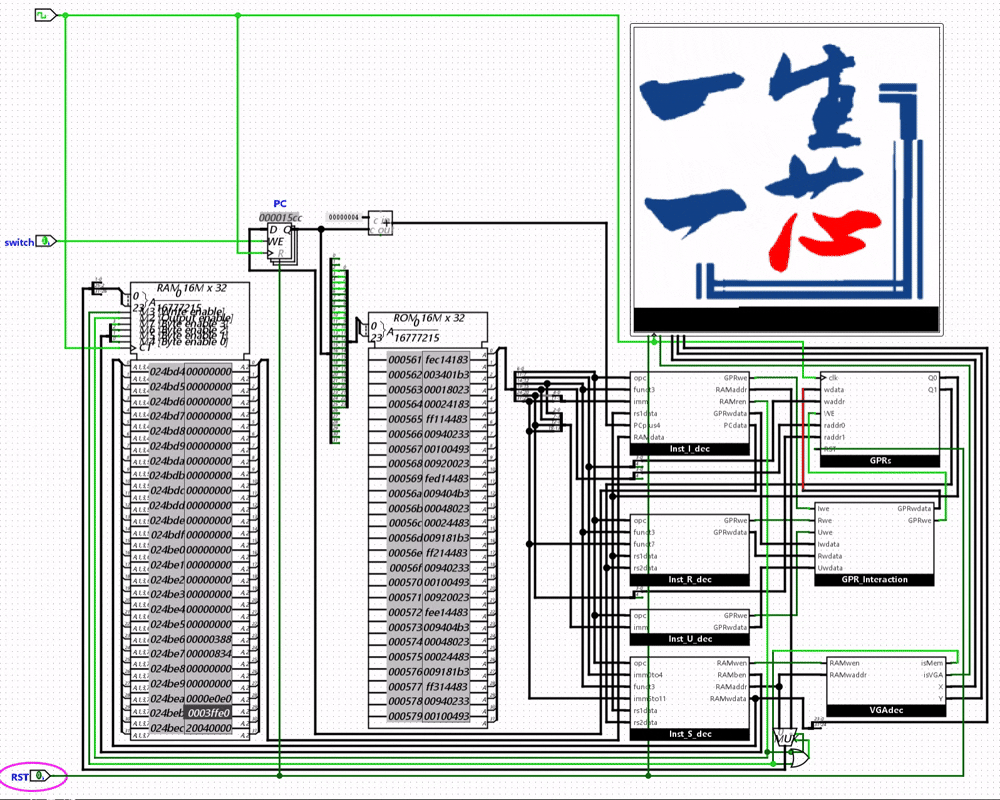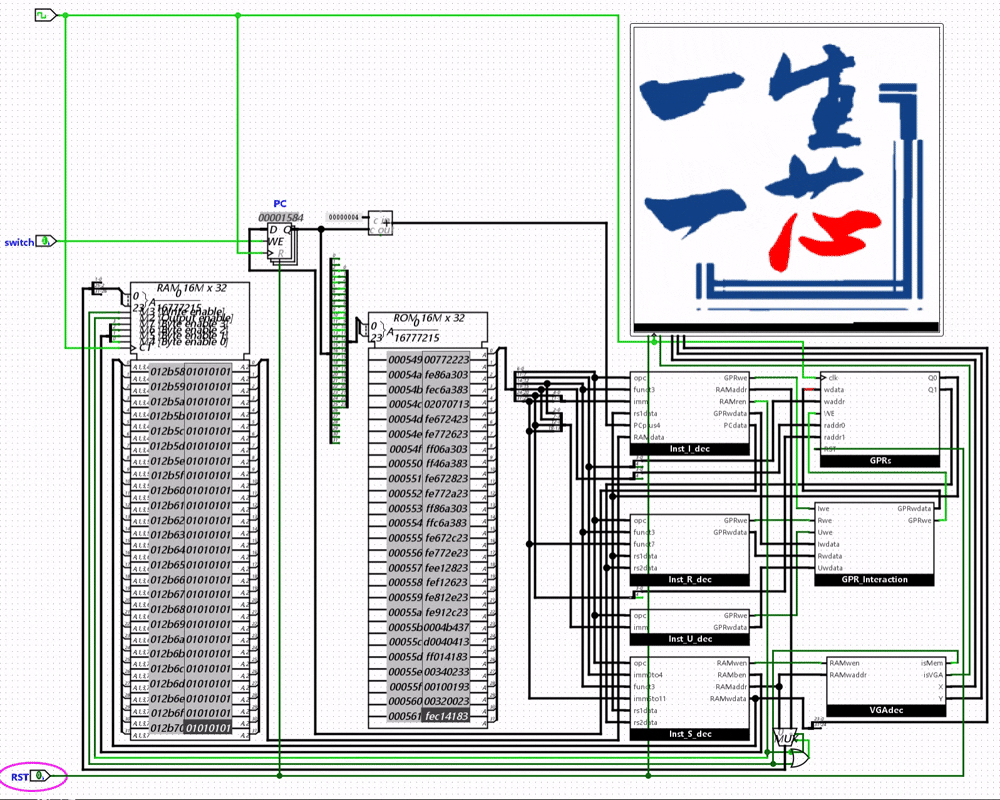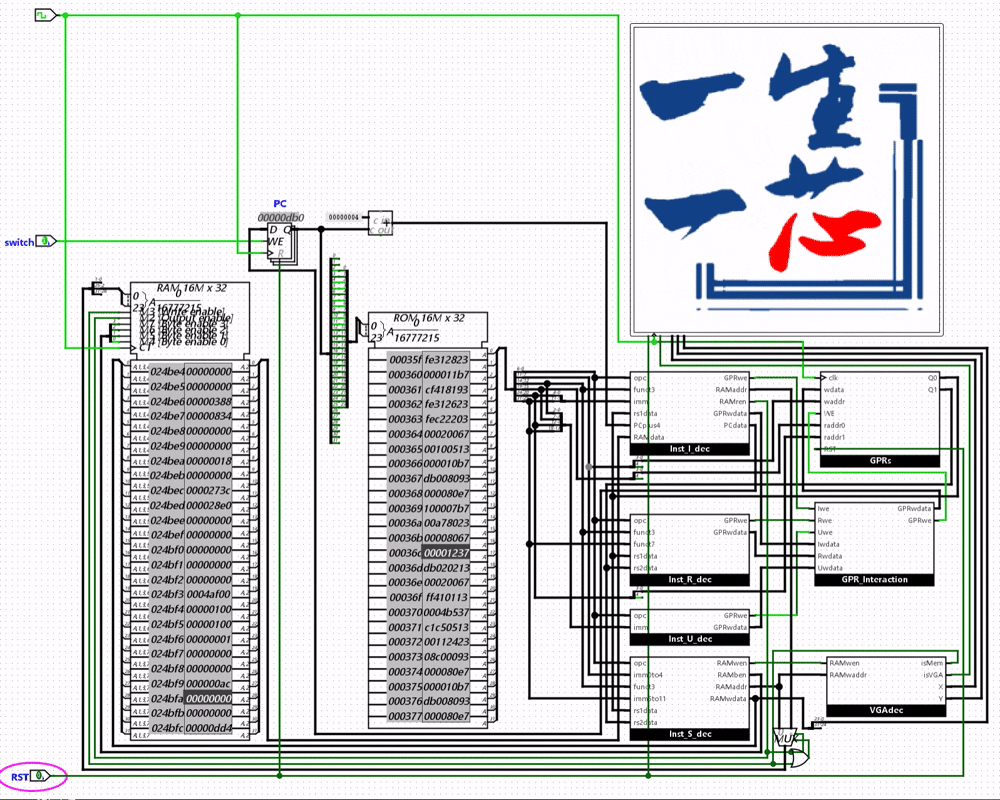
泛用扩展
事实上, 稍微研究一下vga.hex镜像的反汇编代码, 可以发现图片的渲染流程其实并不是把像素数据写死在一条条sw指令里, 而是分成了两个部分:
-
像素渲染控制流: 负责把像素搬到 VGA 窗口的控制流, 下文称
runtime. -
图像数据: 包含像素数据的数据段.
明白这一点后, 就可以在不清楚控制流原理的情况下直接复用它, 从而实现通用的图片渲染.
逆向思路
分析一生一芯片官方给出的vga反汇编文本. 入口附近大致是:
00000000 <_start>:
       0:   00000413            addi    s0,zero,0
       4:   00093137            lui sp,0x93
       …
00000018 <display_image>:
      38:   0004b6b7            lui a3,0x4b
      3c:   f0068693            addi    a3,a3,-256 # 4af00 <image>
注意到注释里的# 4af00 <image>, 源程序里有一个叫image的符号, 链接之后落在字节地址0x4af00. 再结合 hex 的体积(256 × 256个字的图像数据正好接在这个地址后面), 可以把整份镜像分为两个部分:
| 字节区间 | 内容 |
|---|---|
[0x0, 0x4af00) | runtime: 代码 + 查表等, 负责初始化并把像素sw进 MMIO |
[0x4af00, 0x4af00 + 256×256×4) | image 载荷: 行优先帧缓冲, 每像素一字 |
像素字的打包方式与前面 VGA 编码约定一致:
反汇编里还能看到把目的地址装成0x20000000、再调用memcpy / ioe_write一类例程的片段, 也就是把image拷进[0x20000000, 0x20040000). 于是整条渲染链路的本质就是:
固定的 blit 程序 + 一块可替换的图像数据.
为什么不自己写一套显示循环
minirv32尚未实现条件分支, 官方vga能循环起来, 靠的是大段查表去模拟beq / blt等控制流, 体积不小. 若从零生成一套可执行的 blit, 成本远高于「保留官方 runtime、只改像素区」. 这也是后面汇编工具采取模板拼接而不是重写程序的原因.
既然载荷地址和编码都是固定的, 那么渲染别的图片也就不难实现了:
-
把
vga.hex当作可执行模板, 保留[0x0, 0x4af00)部分的代码和查表等逻辑不动; -
用新图生成
65536个0x00RRGGBB字, 写回0x4af00起的数据段; -
ROM 与 RAM 加载同一份新镜像, 复位运行.
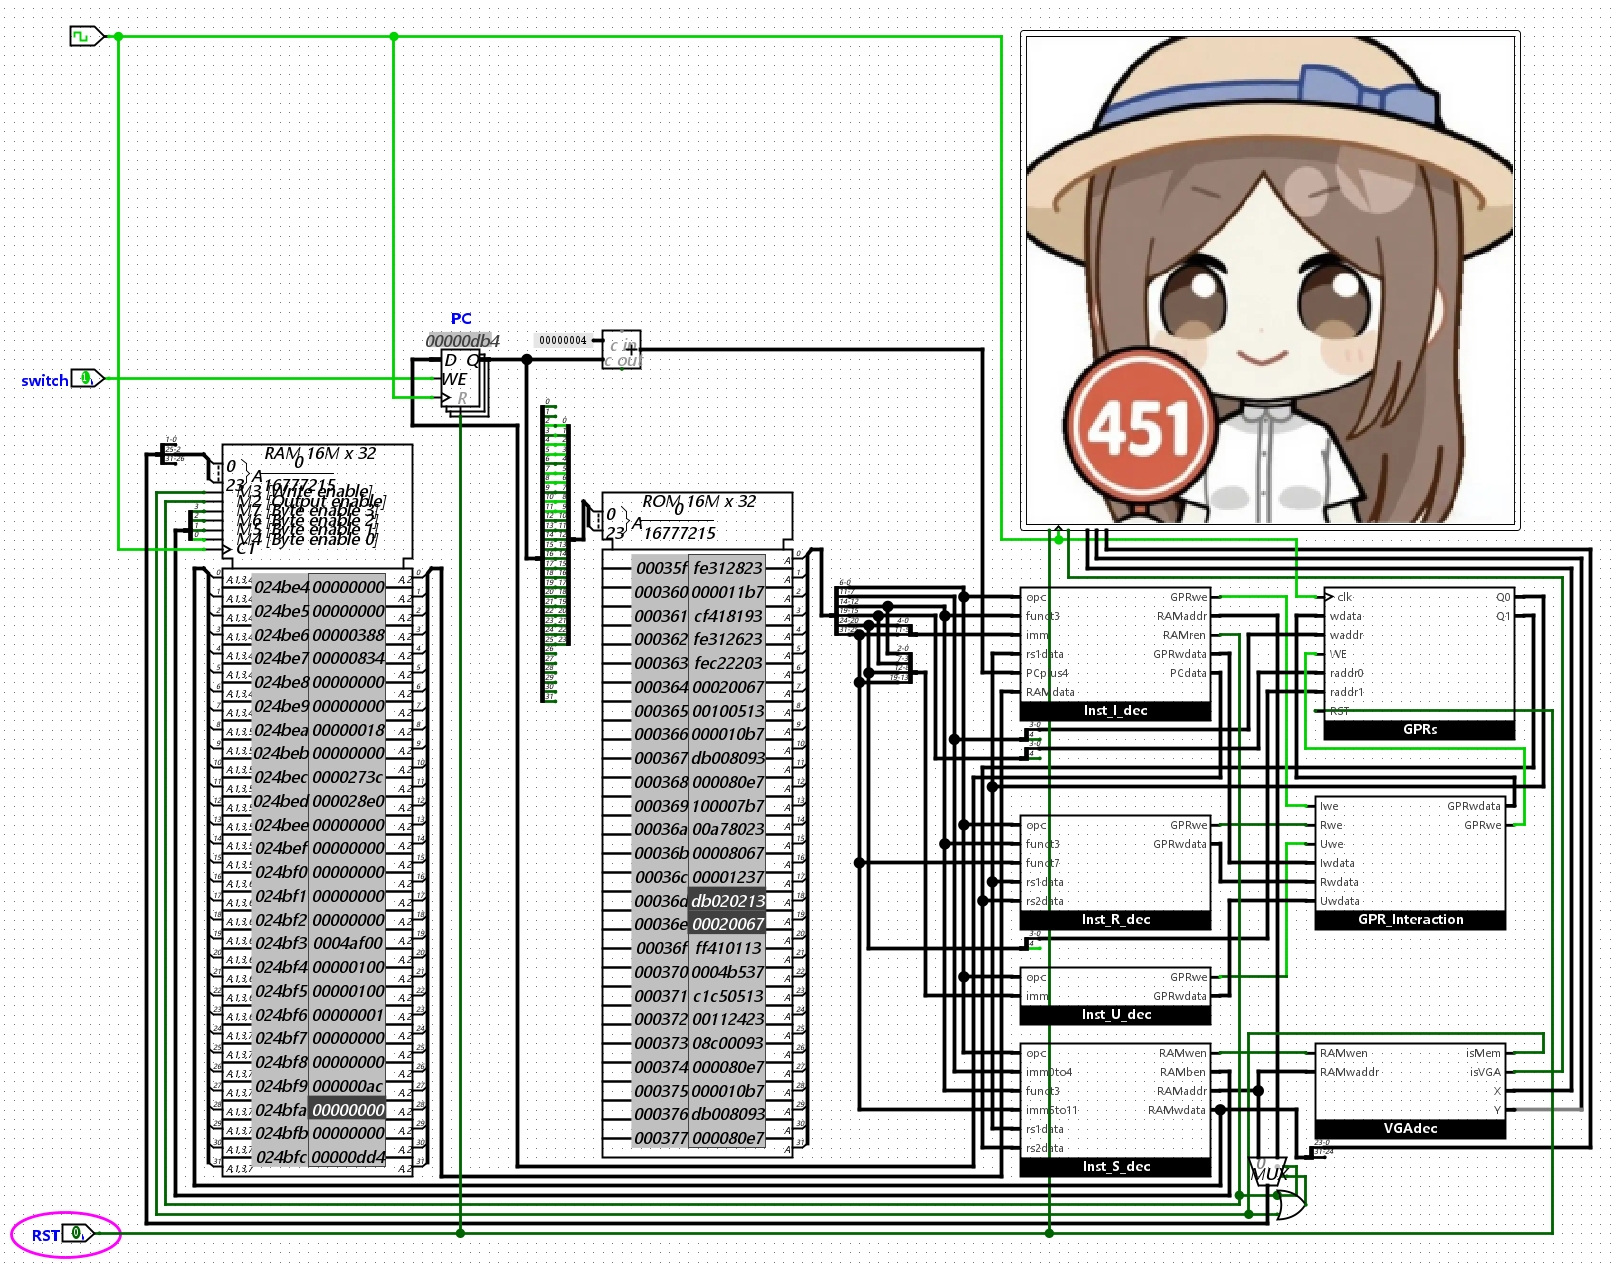
picasm工具链
流程固定且机械, 思考到这里, 就完全可以实现一个工具链来实现自动化.
这里我借助AI快速实现了一个工具链, 并将其命名为picasm. 工具链与上面实现的minirv32处理的Logisim电路工程文件放在同一个仓库: virtualguard101/minirv32.
它不是通用的RISC-V汇编器, 而是专门用于图片(长宽比为1:1的方图), .hex镜像和可读汇编之间的相互转换.
| 命令 | 功能 |
|---|---|
build | 图片 → 可执行的.hex(可选同时写出.asm) |
asm | 图片 → .picasm列表 |
disasm | 现有.hex → 汇编(picasm可往返 / objdump风格对照) |
assemble | .picasm → 可执行.hex |
extract | .hex或.asm → 还原图片 |
工作原理则与上面的逆向结论一一对应, build和assemble读取bin/vga.hex在image之前的前缀, 再拼上新的像素字列; extract则按0x4af00切出载荷并解成图片.
面向往返的汇编采用一种看似汇编, 实际上更接近伪代码的语法, 核心是声明布局并把像素写成.word, 例如:
.picasm 1
.width 256
.height 256
.image_offset 0x4af00
.format rgb888
.runtime "vga"

.section image
image:
  .word 0x00ffffff, 0x00ffffff, ...
.runtime "vga"表示组装 hex 时继续拼官方前缀; 像素只来自image:段. 默认情况下不会把七万多字的runtime全部写入文本(否则列表会大到难以阅读); 若确实需要, 可以使用参数--embed-runtime. 另外还提供--style objdump的反汇编输出, 方便对照学习指令流, 但不携带完整图像载荷.